
国庆节10月1日
--
Python 语法速查与常用算法模板合集,含 97 张配图(原笔记 6180 行)
固定模板
import sysimport mathimport bisectimport heapq
from collections import ( deque, Counter, defaultdict)
from functools import lru_cachefrom itertools import permutations, combinations, accumulatefrom operator import itemgetter
# ==================== 快速输入 ====================
# 方式一:按行读取,适合普通输入input = sys.stdin.buffer.readline
# 读取一行整数n, m = map(int, input().split())
# 读取一行数组a = list(map(int, input().split()))
# 方式二:一次性读取全部输入,适合数据量特别大# data = list(map(int, sys.stdin.buffer.read().split()))# index = 0# n = data[index]# index += 1
# ==================== 数学函数 math ====================
# 最大公约数g = math.gcd(12, 18) # 6
# 最小公倍数l = math.lcm(12, 18) # 36
# 平方根x = math.sqrt(16) # 4.0
# 向上取整、向下取整up = math.ceil(3.2) # 4down = math.floor(3.8) # 3
# 阶乘f = math.factorial(5) # 120
# 组合数 C(n, k)c = math.comb(5, 2) # 10
# 无穷大INF = 10**18
# 负无穷NEG_INF = -10**18
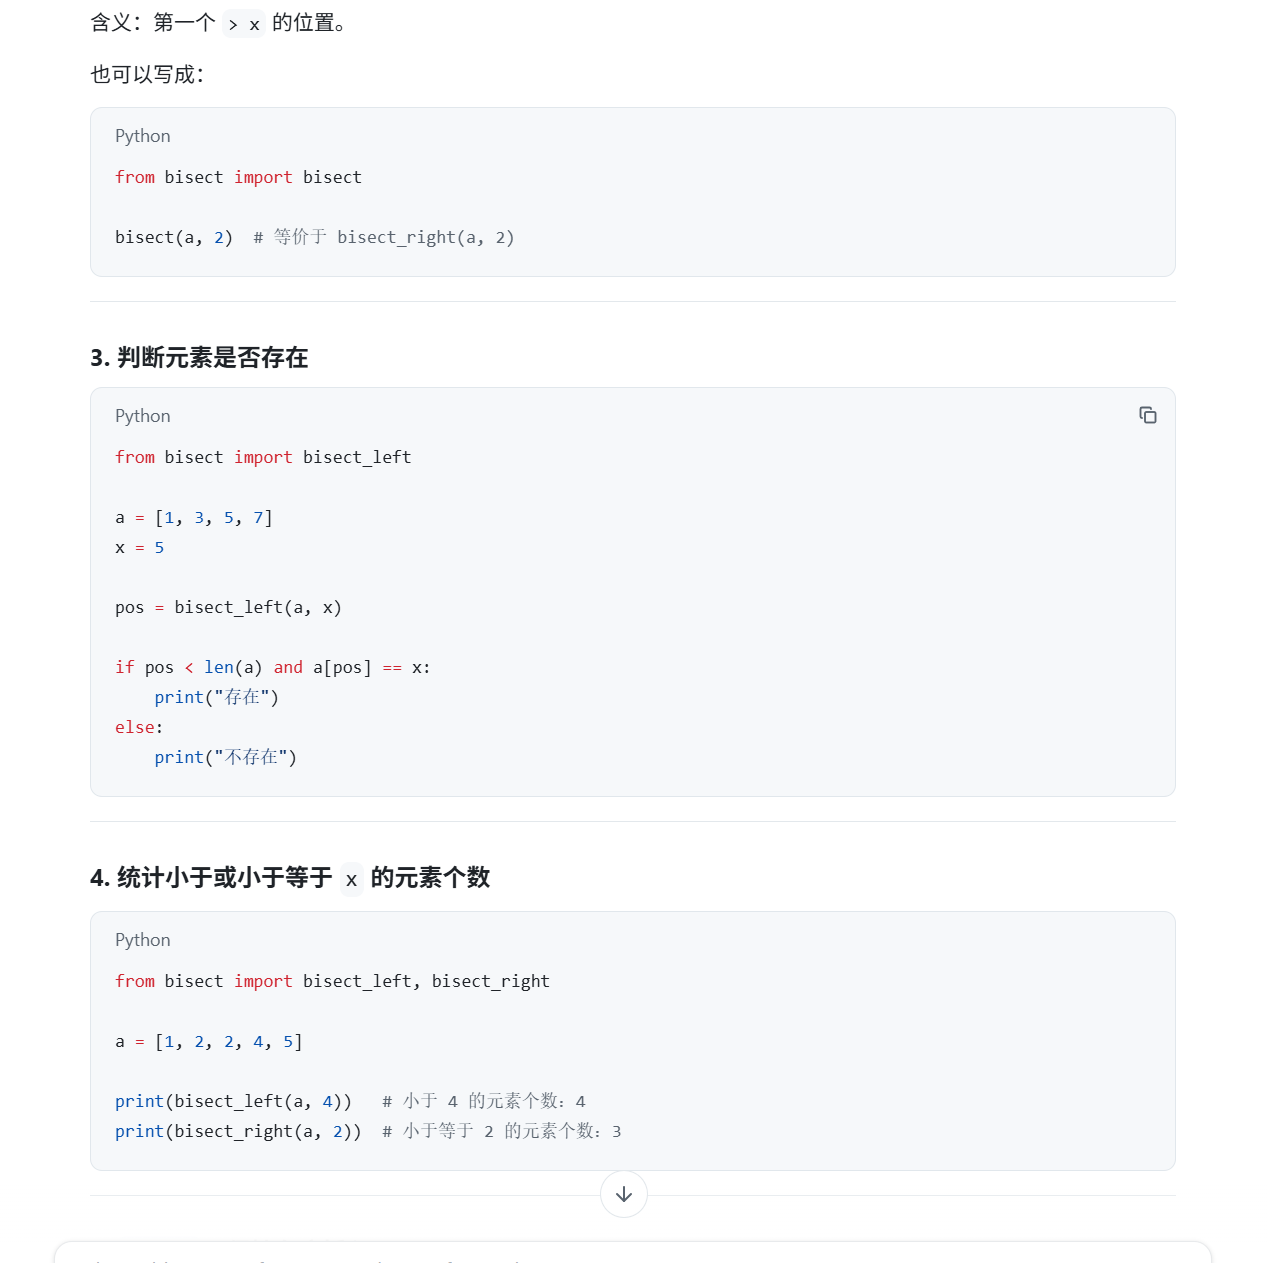
# ==================== 二分 bisect ====================
a = [1, 2, 2, 4, 6]
# 第一个大于等于 x 的位置left = bisect.bisect_left(a, 2) # 1
# 第一个大于 x 的位置right = bisect.bisect_right(a, 2) # 3
# 统计 x 出现次数count = bisect.bisect_right(a, 2) - bisect.bisect_left(a, 2)
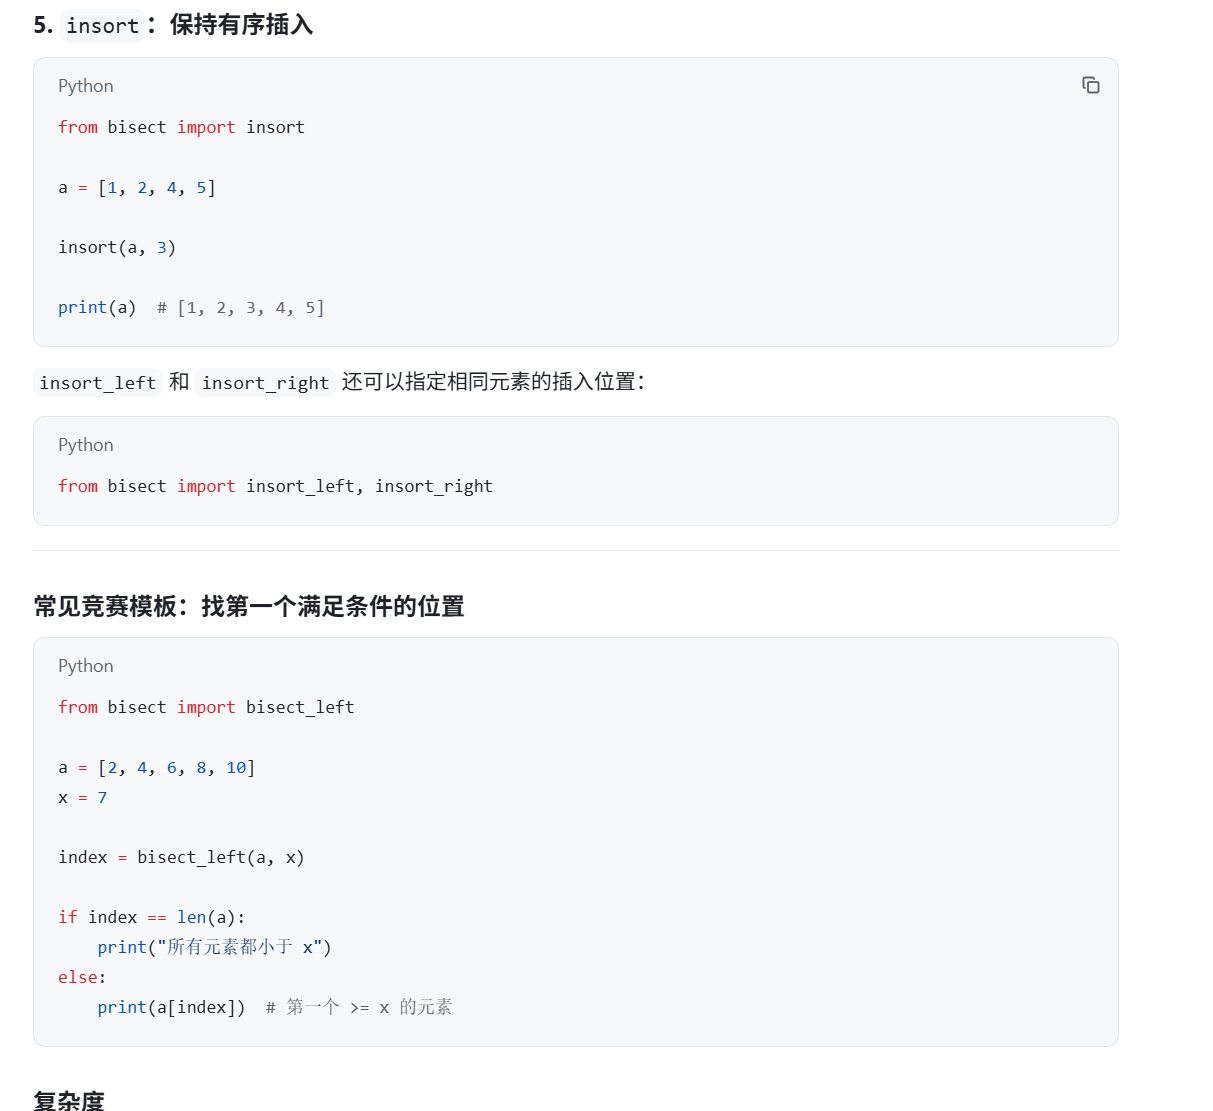
# 向有序数组中插入元素,保持有序bisect.insort(a, 3)
# ==================== 队列 deque ====================
q = deque()
# 入队q.append(1)
# 从队头出队x = q.popleft()
# 从队尾入队q.appendleft(2)
# 从队尾出队x = q.pop()
# ==================== BFS 常用写法 ====================
directions = [ (-1, 0), # 上 (1, 0), # 下 (0, -1), # 左 (0, 1) # 右]
queue = deque()queue.append((0, 0))
while queue: x, y = queue.popleft()
for dx, dy in directions: nx = x + dx ny = y + dy
# ==================== 堆 heapq ====================
# Python 默认是小根堆heap = []
heapq.heappush(heap, 5)heapq.heappush(heap, 2)heapq.heappush(heap, 8)
# 取出最小值smallest = heapq.heappop(heap)
# 查看堆顶但不删除top = heap[0]
# 模拟大根堆:存入负数max_heap = []
heapq.heappush(max_heap, -10)heapq.heappush(max_heap, -3)
# 最大值maximum = -heapq.heappop(max_heap)
# ==================== Counter 计数 ====================
a = [1, 2, 2, 3, 3, 3]
cnt = Counter(a)
# cnt[3] == 3# 出现次数最多的元素most_common = cnt.most_common(1)
# ==================== defaultdict ====================
# 不存在的键默认值为 0freq = defaultdict(int)
for x in a: freq[x] += 1
# 默认创建空列表graph = defaultdict(list)
graph[1].append(2)graph[2].append(3)
# ==================== 前缀和 accumulate ====================
a = [1, 2, 3, 4]
prefix = list(accumulate(a))# prefix = [1, 3, 6, 10]
# 区间 [l, r] 的和:# prefix[r] - prefix[l - 1]# 注意这里假设下标从 1 开始
# ==================== 缓存递归结果 ====================
@lru_cache(None)def fib(n): if n <= 1: return n
return fib(n - 1) + fib(n - 2)
# ==================== 主程序 ====================
def solve(): # 在这里写题目代码 pass
if __name__ == "__main__": solve()import sysimport mathimport bisectimport heapqsys.set_int_max_str_digits(0)sys.set_int_max_str_digits(0)from collections import deque, Counter, defaultdictfrom functools import lru_cache
input = sys.stdin.buffer.readline
INF = 10**18
directions = [ (-1, 0), (1, 0), (0, -1), (0, 1)]
def solve(): n = int(input()) a = list(map(int, input().split()))
# 在这里写代码
if __name__ == "__main__": solve()课程(知识点)TsingPig视频专辑-TsingPig视频合集-哔哩哔哩视频
https://github.com/TsingPig/Lesson_Python_TsingPig.git
https://wiki.dwj601.cn/ds-and-algo/templates-py/
课程(带刷)【假期逆袭!算法竞赛入门速成】蓝桥杯、天梯赛(python组)第一章 基础练习_哔哩哔哩_bilibili
课程(带刷力扣)算法路飞的个人空间-算法路飞个人主页-哔哩哔哩视频
灵神https://github.com/EndlessCheng/codeforces-go/blob/master/leetcode/README.md
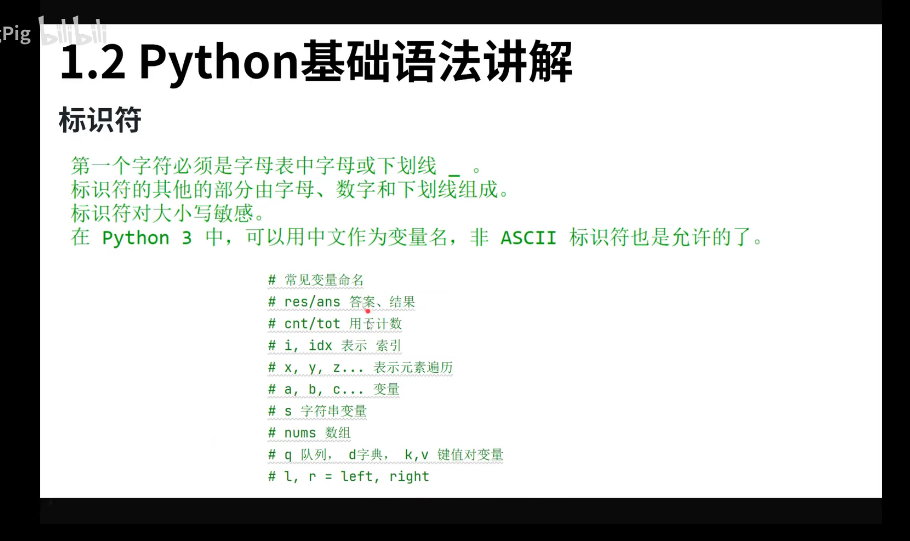
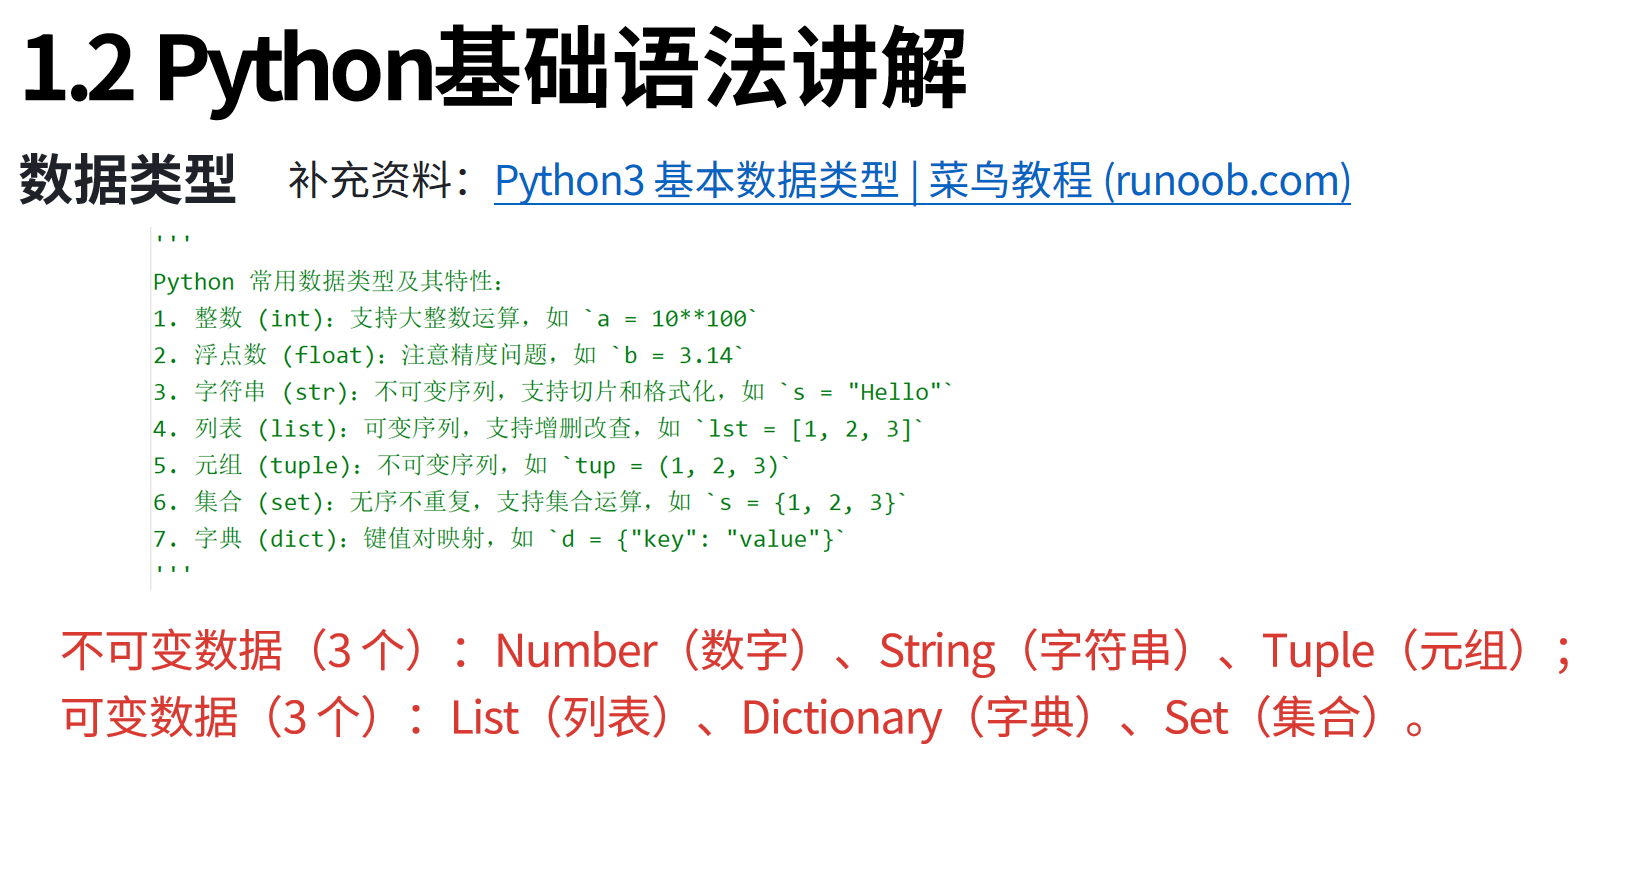
# int 整数# float 浮点数# str 字符串 不可变序列 s="Hello"# list 列表,增删改查,'list=[1,2,3]'# tuble 元组 不可变序列 'tub=(1,2,3)'# set 集合 无序不重复 支持集合运算 's={1,2,3}'# dict 字典 类似于C++map 'd={"key","value"}'import sysdef main(): data = list(map(int, sys.stdin.read().split()))
if __name__ == "__main__": main()# Python 固定写法:当直接运行这个 py 文件时,执行 main () 函数。导入系统模块,用来一次性读取全部输入。竞赛里sys.stdin.read()是高速读入,比循环input()快很多,处理 2e5 大数据不会超时
定义主函数,把所有逻辑包进去。Python 推荐写在函数里,运行速度比全局代码更快
sys.stdin.read():一次性读取全部输入文本,把所有输入当成一整个长字符串。.split():按空白(空格、换行、回车)切分成一串字符串,不管有多少行。map(int, ...):把每一段字符串转成整数。list(...):转为整数列表,全部输入数字顺序存到data。举例样例输入:
data会变成:[6,5,4,1,2,3,4,4, ...] 好处:不用一行一行读,规避多次 IO 带来的巨大耗时
import sys
def main(): data = list(map(int, sys.stdin.read().split())) # `p`是**指针(索引)**,标记我们现在读到`data`列表第几个数字。初始从第 0 位开始 p = 0
t = data[p] p += 1 for _ in range(t): n = data[p] m = data[p+1] p += 2
stx = [0] * (m + 1) # stx[0 ~ m),多开一位防止越界 for __ in range(n): val = data[p] p += 1 stx[val] += 1
# 后缀和 stx1[x] = sum_{i >= x} stx[i] stx1 = [0] * (m + 2) for x in range(m, 0, -1): stx1[x] = stx1[x + 1] + stx[x]
ans = 0 for x in range(1, m + 1): l1 = stx1[x + 1] l2 = 0 if 2 * x <= m: l2 = stx[2 * x] cnt = stx[x] + l1 + l2 if cnt > ans: ans = cnt print(ans)
if __name__ == "__main__": main()import sysinput = sys.stdin.readline
def main(): t = int(input()) for _ in range(t): n, m = map(int, input().split()) arr = list(map(int, input().split())) stx = [0]*(m+1) for v in arr: stx[v] += 1 stx1 = [0]*(m+2) for x in range(m,0,-1): stx1[x] = stx1[x+1] + stx[x] ans = 0 for x in range(1, m+1): l1 = stx1[x+1] l2 = 0 if 2*x <= m: l2 = stx[2*x] cnt = stx[x] + l1 + l2 ans = max(ans, cnt) print(ans)
if __name__ == "__main__": main()对标C++
#include<bits/stdc++.h>
using namespace std;
int main(){ int t; cin>>t;
while(t--){ int n,m; cin>>n>>m;
vector<int> stx(m+1,0); vector<int> stx1(m+2,0); //vector<int> stx2(2*m);
for(int i=0;i<n;i++){ int x; cin>>x;
stx[x]++; }
for(int x=m;x>=1;x--){ stx1[x]=stx1[x+1]+stx[x]; }
int ans=0;
for(int x=1;x<=m;x++){ int l1=stx1[x+1];
int l2=0;
if(2*x<=m){ l2=stx[2*x]; }
int cnt=stx[x]+l1+l2; ans=max(ans,cnt); }
cout<<ans<<endl; }
return 0;}import sysinput = lambda: sys.stdin.readline().strip()n=int(input())print(n)# a b 输入以空格分割a,b=map(int ,input().split())print(a+b)
print(n,a,b)
# Python print 默认自动换行
# 手动取消换行print("输出列表:",end=' ')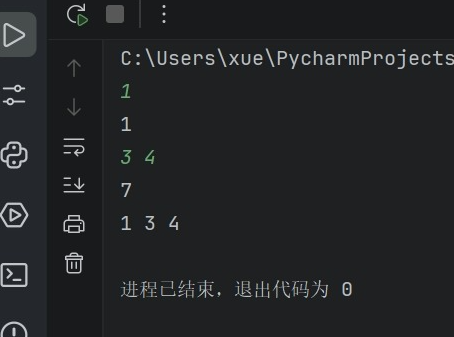
对标vector
# list# 它的作用:**读入一行空格隔开的数字,转成整数列表**lis=list(map(int,input().split()))print("输出列表:",end=' ')print(lis)# 尾部添加元素lis.append(19)print("输出列表:",end=' ')print(lis)
print("不带括号版:",end=' ')print(*lis)
# 输出某个元素print("第一和第二个元素:",end=' ');print(lis[0],lis[1])
# 计算总会sum(lit)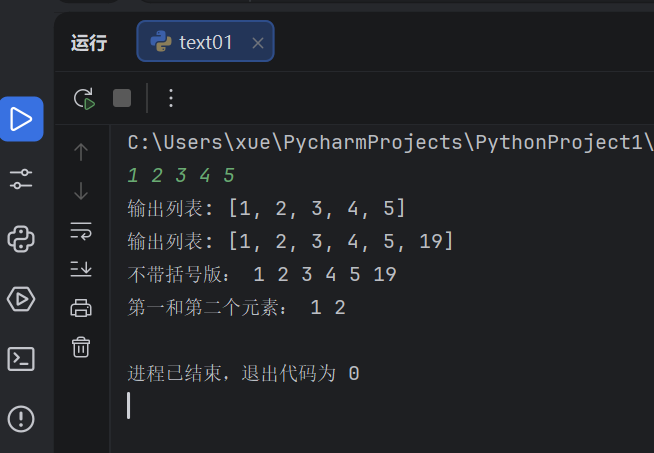
# list 列表 里面可以放不同的数据类型
# listext = ["string",2,3,4,5]
list1 =[1,2,3,4,5]
# print(list1[0])# 无索引默认删第一个,有索引按索引删list1.pop()print(list1)list1.pop(0)print(list1)
# append 末尾添加
list1.append(5)print(list1)print("list1的长度为 ",end='')print(len(list1))
# insert 插入 在对应位置插入对应元素list1.insert(0,1) #前面是索引位置,后面是位数据print(list1)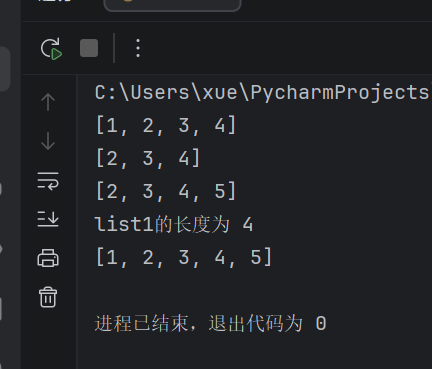
list1=list(map(int ,input().split()))# 排序list1.sort()print(list1)
# 翻转list1.reverse()print(list1)
# 删除指定值 remove(只删第一个) ||| pop 是删除指定索引值
list1.remove(1)print(list1)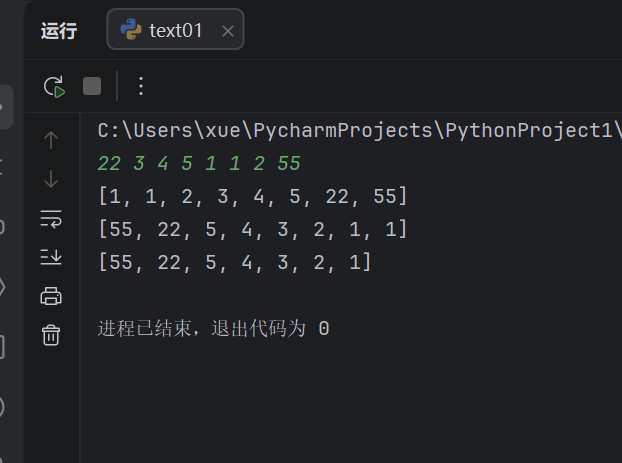
list1=list(map(int ,input().split()))# 排序 默认从小到大list1.sort()print(list1)# 从大到小# 法1list1.sort(reverse=True)print(list1)# 法2b = sorted(list1, reverse=True)print(b)# 翻转list1.reverse()print(list1)
# 删除指定值 remove(只删第一个) ||| pop 是删除指定索引值
list1.remove(1)print(list1)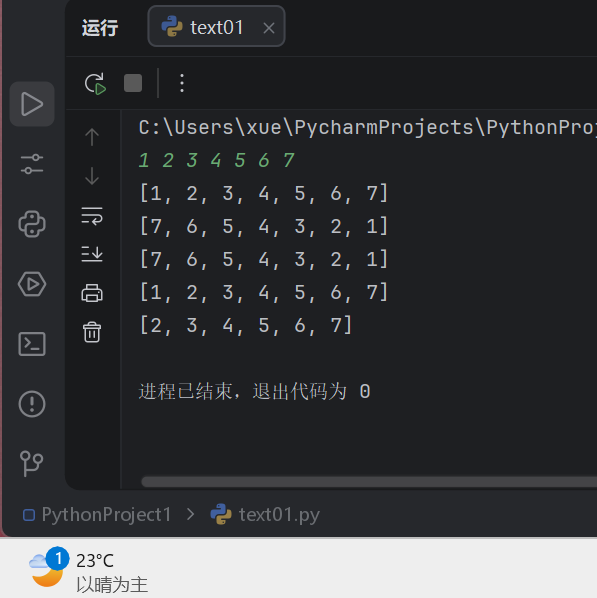
不变的列表
# 操作 和列表不变的部分一样# 输出,列表[],元组 ()tuple1=(1,2,3)
print (tuple1)# 转化为list 操作print (list(tuple1))list1 = list(tuple1)list1[0]=0print(list1)
tub2=tuple(list1)print(tub2)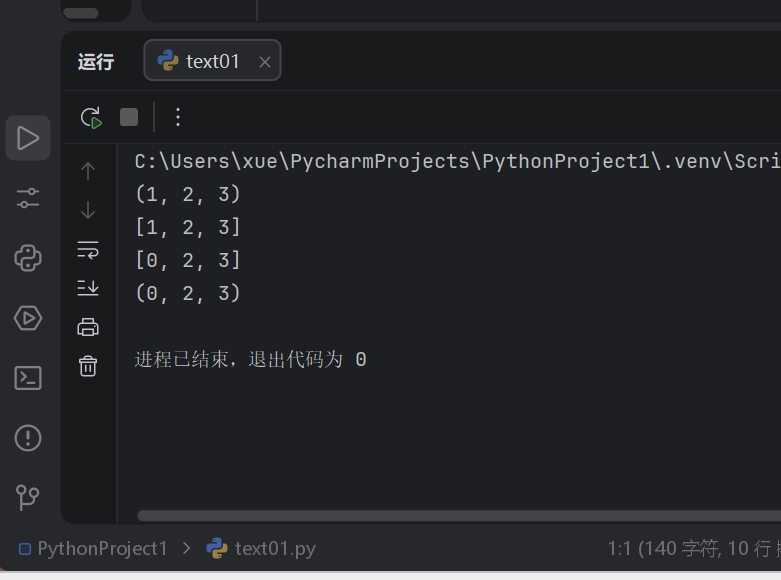
Python 里字符串str是不可变类型,不能直接写 s[i] = '.' 修改字符串里某个字符!
str1="hello"str2=" Selina"
print(str1+str2)# [l:r]:左闭右开 [l,r)print(str1[0:4])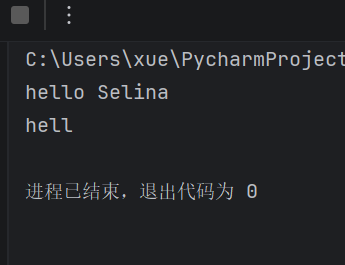
s1="hello boy"s2="Oh No"//加号print(s1+s2)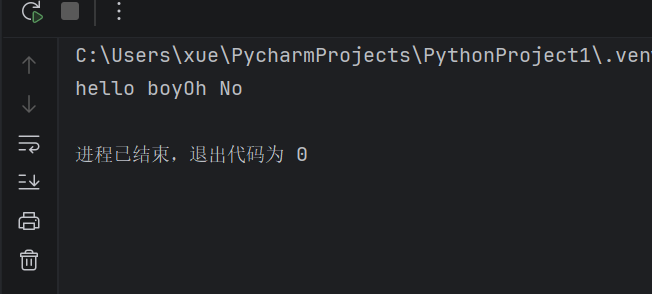
s1="hello boy"
# len length
print(len(s1))
# capitalize 首字母大写
print (s1.capitalize())
# upper 全部大写
print(s1.upper())
s1="OH BOY"# lower 全部小写
print(s1.lower())
# replace 把第一个参数替换为第二个
print(s1.replace("BOY","Selina ,I miss you"))
# find 查找 报告第一个出现的索引
print(s1.find("BOY"))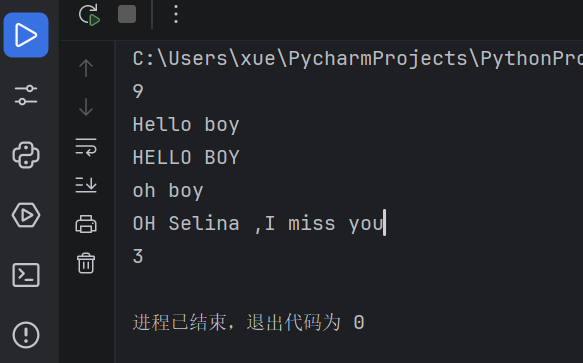
s1="hello boy"s2="HELLO WORLD"# bool# a = True# b = False
# isupper 判断是否都是大写
print(s1.isupper())print(s2.isupper())
s1="hello boy"s2="HELLO WORLD"
print(s1.split('o',1))# 判断结尾是否匹配print(s1.endswith("boy"))
s = input() # 读取一行,回车结束;得到字符串,包含空格,**自动去掉末尾换行符**
print(s)
# 输入:hi pythonlst = input().split()print(lst) # ['hi', 'python']
strip()的作用是:删除字符串开头和结尾的空白字符,包括空格、换行 \n、制表符 \t 等。
s = input().strip()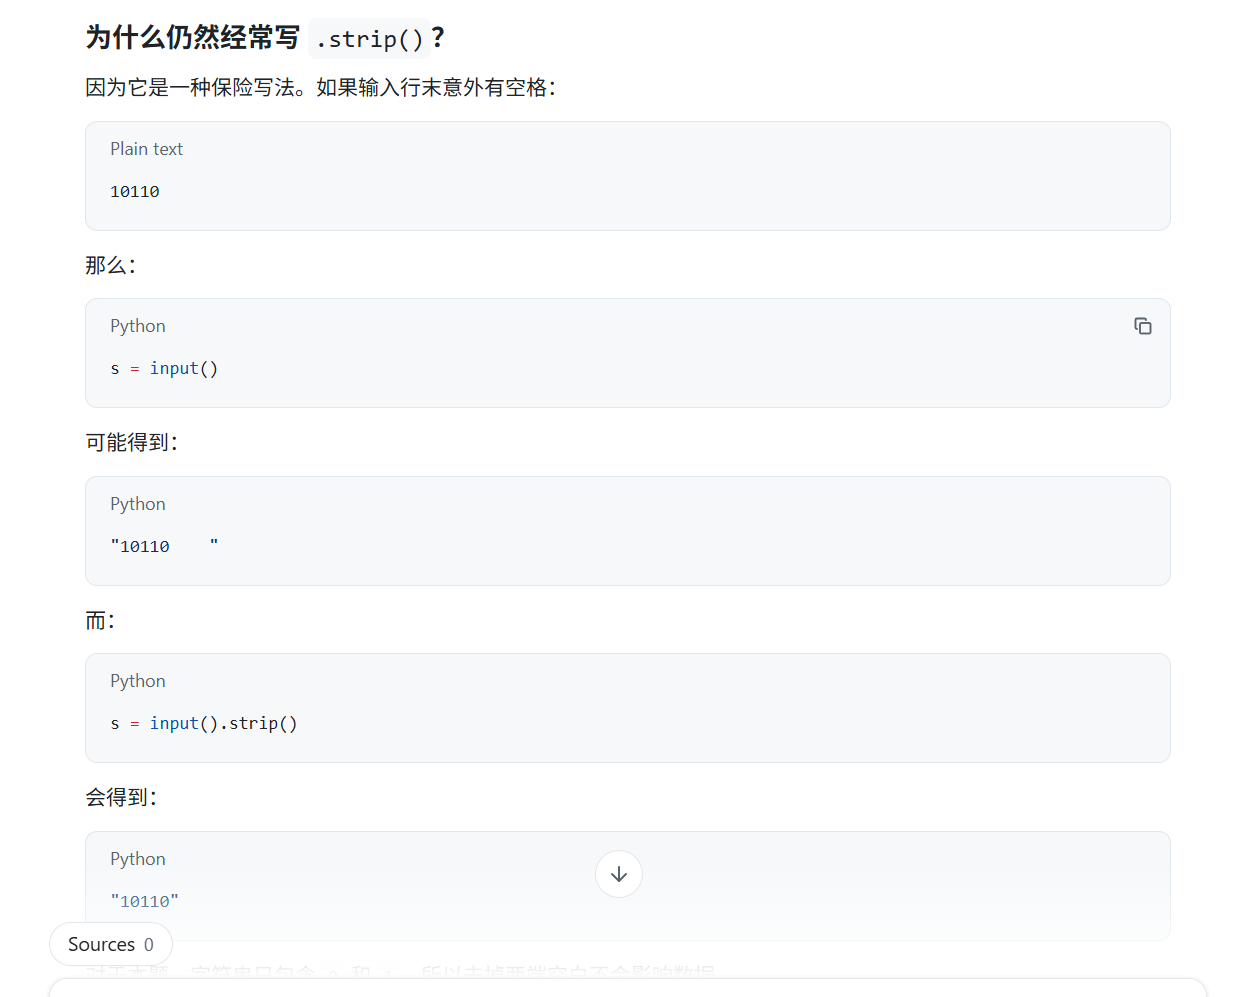
import sysinput = sys.stdin.readline
def main(): t=int(input()) for _ in range(t):
n,k=map(int,input().split()) s=input().strip()
cnt=[0] * k
for i in range(n): if(s[i]=='1'): cnt[i%k]+=1
ok=True
for i in range(k): if(cnt[i]%2!=0): ok=False break
print("YES" if ok else "NO")
if __name__ == "__main__": main()import sys;input=lambda:sys.stdin.readline().strip()
n=input()print(f"I am {n} and I am studying Python in Nowcoder!")
class Solution: def lengthOfLastWord(self, s: str) -> int: asd=s.split() return len(asd[-1])s.split() 默认按空白(空格、换行、多个空格)切分字符串,得到单词列表。 asd[-1] 取最后一个单词,len()求它的长度。
功能:返回字符串最后一个单词的长度(LeetCode 58. 最后一个单词的长度
index() 用来查找元素在列表中的下标。
# 函数# 定义 defdef get_sum(sum1,sum2): return sum1+sum2
a,b=map(int,input().split())
print(get_sum(a,b))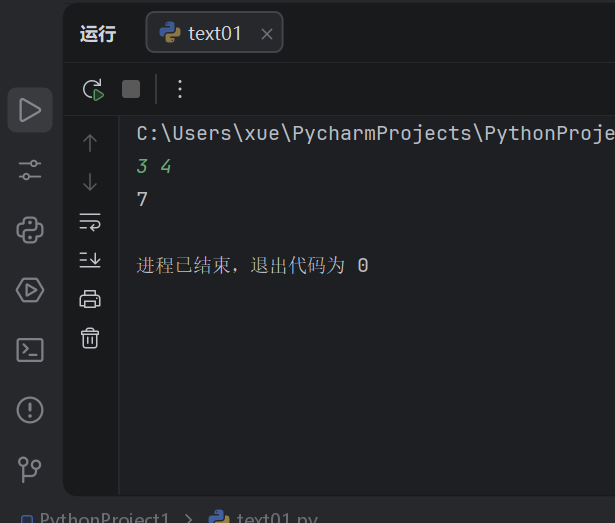
在上面的实践中可以发现,除法运算(/)永远返回浮点类型(在 Python 2 中返回整数).如果你想要整数或向下取整的结果的话,可以使用整数除法(//).同样的,你也可以像 C++ 中一样,使用模(%)来计算余数,科学计数法的形式也相同.
# 数字
a=9b=2c=a+1print(a/b)print(c/b)# 强转print(int(a/b))print(a//b)
print(a%b)
# absa=-9print(a/2)
print(abs(a/2))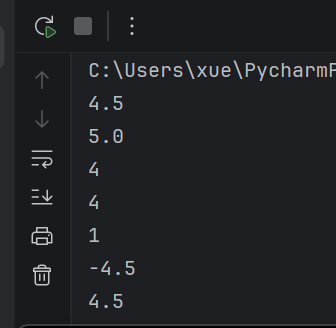
import math# round:四舍五入a=3.4print(round(a))a=3.5print(round(a))
# pow 幂
print(pow(a,2))
#ceil 引入math模块 向上取整print(math.ceil(a))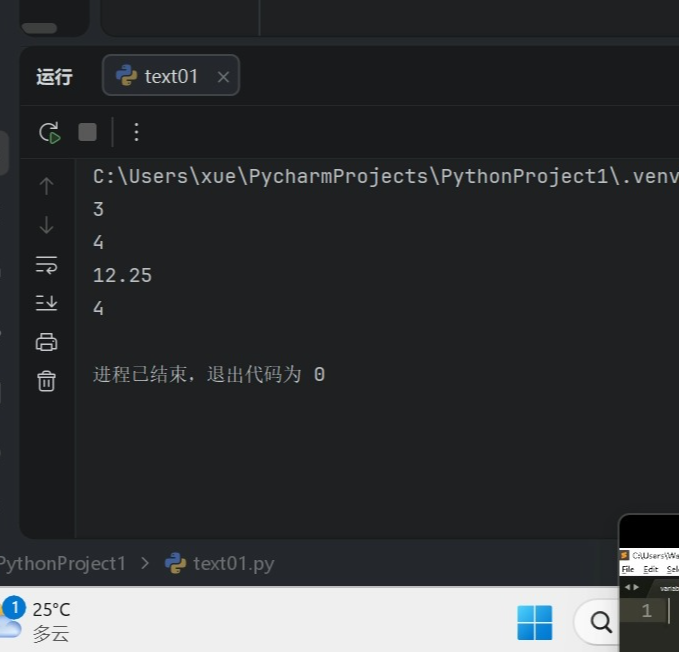
重点 后续要打磨
kiys / values 键值对
Python dict 等价 C++ unordered_map(哈希表);C++ map 是有序版本,Python 里想要有序要额外 sorted
# dict 键值对,通过键查找值dict1={"name":"老张","height":170,"weight":100}
print(dict1["name"])
print(len(dict1))# 获得键print(dict1.keys())#获得值print(dict1.values())
# 添加或修改dict1["name"]="Aurora"print(dict1["name"])
dict1["gender"]="man"print(dict1.keys())
# 删除dict1.pop("name")print(dict1.keys())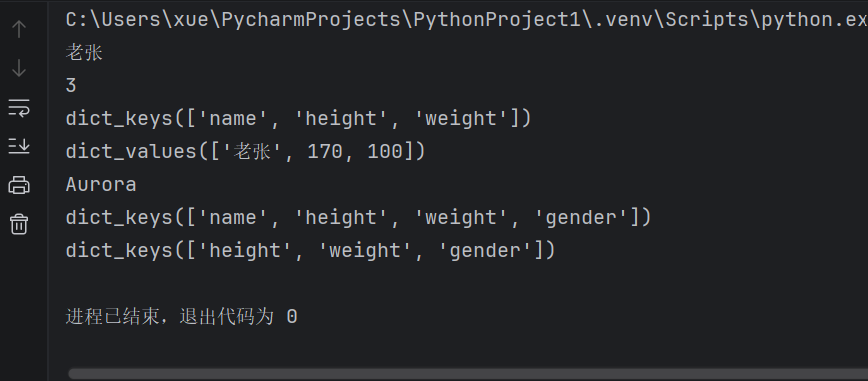
map<string,int> cnt;cnt = dict() # 字典,等价C++ map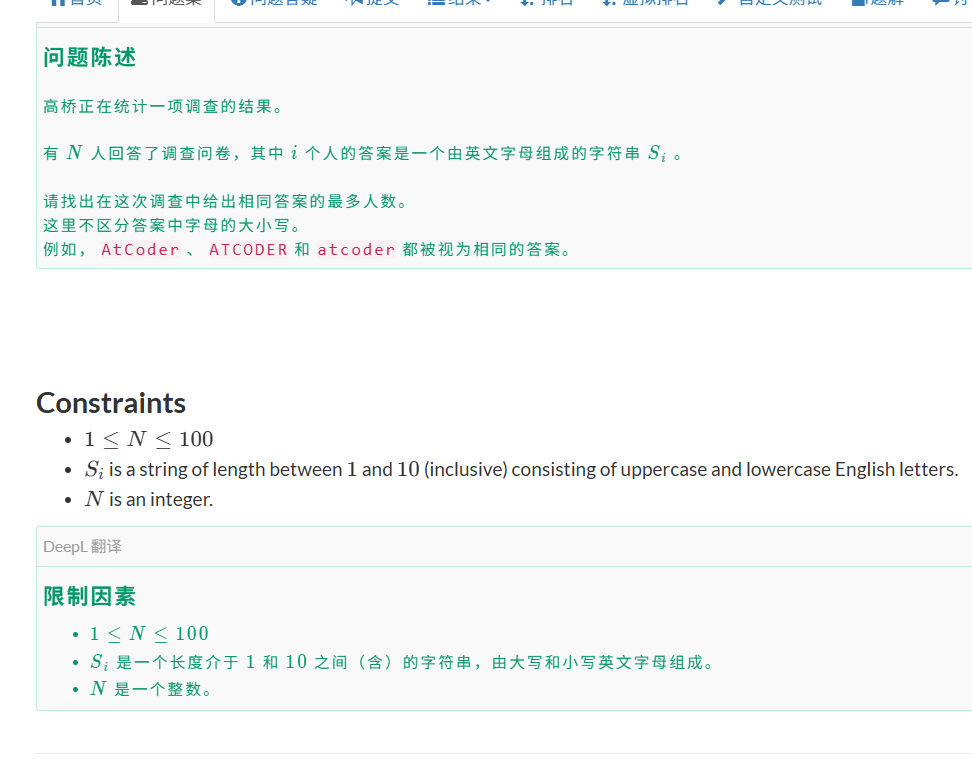
n = int(input())st = []for _ in range(n): s = input() st.append(s)
cnt = dict() # 字典,等价C++ map
for s in st: s_lower = s.lower() # 全部转小写,和C++里^32效果一样 if s_lower in cnt: cnt[s_lower] += 1 else: cnt[s_lower] = 1
ans = 0for v in cnt.values(): ans = max(ans, v)
print(ans)对标C++
#include<bits/stdc++.h>using namespace std;int main(){ int n; cin>>n;
vector<string> st(n);
for(int i=0;i<n;i++){ cin>>st[i]; }
map<string,int> cnt;
for(int i=0;i<n;i++){ for(int j=0;j<st[i].size();j++){ if(st[i][j]>='A'&&st[i][j]<='Z'){ st[i][j]^=32; } }
cnt[st[i]]++; }
int ans=0; for(auto & p:cnt){ int v=p.second; ans=max(ans,v); } cout<<ans<<endl;}set 无重复元素,无顺序 无法索引查找
# set 无重复元素,无顺序 无法索引查找set1={1,3,5,2,2}set2=set((3,4,7,5,6))print(set1)print(set2)
# 添加元素set1.add(10)print(set1)
# 删除元素
set1.discard(2)print(set1)
# 公有的元素print(set1.intersection(set2))# 不同的 1有2没有print(set1.difference(set2))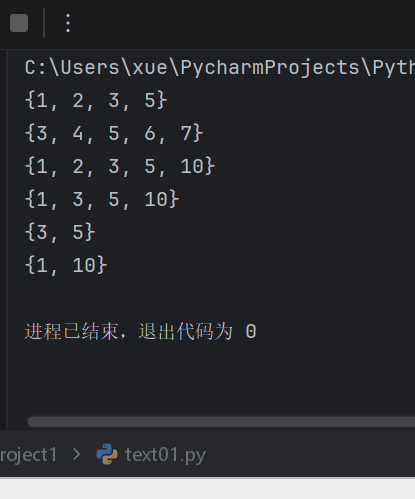
# set 无重复元素,无顺序 无法索引查找set1={1,3,5,2,2}set2=set((3,4,7,5,6))print(set1)print(set2)
# 判断2是不是1的子集print(set2.issubset(set1))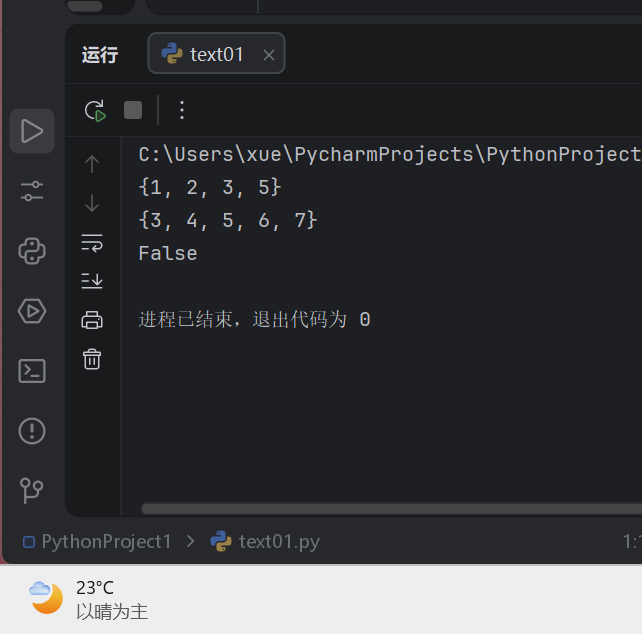
# 从 Python 自带的 `collections` 模块里面,导入 `deque`(双端队列)这个类,**这样你后面代码才能直接写 `deque()` 创建队列**。from collections import deque
# 创建空队列q = deque()
# 入队(队尾添加) appendq.append(1)q.append(2)q.append(3)
# 出队(队头弹出) popleftx = q.popleft()print(x) # 1
# 查看队首元素(不取)print(q[0]) # 2
# 判断队列是否为空if q: print("队列不为空")else: print("空队列")
# 获取长度print(len(q))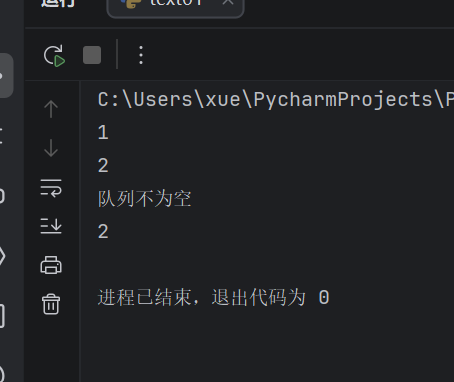
homework_finished=False
if(homework_finished): print("over")else: print("go work")
a=int(input())
if(a==100): print("good")elif (a==1000): print("fuck")else : print("NNNN")x=int(input())list1=[]while x>0 : p=x%10 list1.append(p) x//=10print(*list1)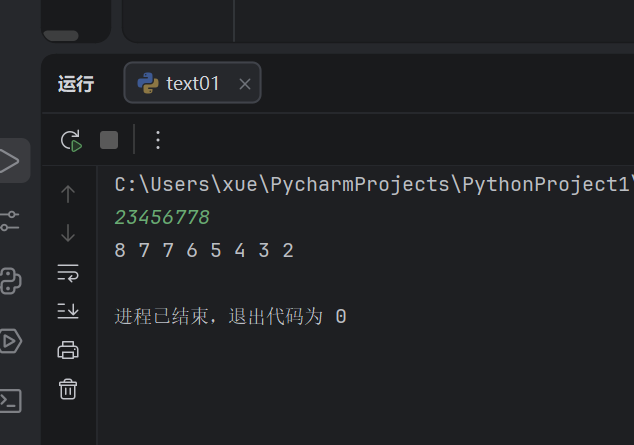
int n = 5;for(int i = 0; i < n; i++){ cout << i << endl;}// 输出:0 1 2 3 4n = 5for i in range(n): print(i)range(n):产生 0,1,2,...,n-1,左闭右开,取不到 ni++,Python 自动帮 i+1// i从1到5,包含5for(int i = 1; i <= 5; i++){ cout << i << endl;}# range(起点, 终点),终点取不到!所以要写5+1=6for i in range(1, 6): print(i)for(int i = 1; i <= 10; i += 2){ cout << i; //1,3,5,7,9}# range(起始,终止,步长)for i in range(1, 11, 2): print(i)for(int i = 5; i >= 1; i--){ cout << i; //5 4 3 2 1}# range(开始,结束,-1);结束值取不到,所以写0for i in range(5, 0, -1): print(i)int arr[] = {10,20,30};for(int i = 0; i < 3; i++){ cout << arr[i];}// 或者C++11范围forfor(auto num : arr){ cout << num;}lst = [10,20,30]for num in lst: print(num)lst = [10,20,30]for i in range(len(lst)): print(lst[i])_(不需要用到循环变量的值,只需要循环跑 n 次)
for(int i=0; i<3; i++){ cout << "hello";}for _ in range(3): print("hello")for(int i = 0; i < 3; i++){ for(int j = 0; j < 3; j++){ cout << i*j << " "; } cout << endl;}for i in range(3): for j in range(3): print(i*j, end=" ") print() #内层循环跑完一行,换行break:直接跳出整个循环continue:跳过本次循环剩下代码,直接进入下一轮| 功能 | C++ 写法 | Python 写法 | 坑点 |
|---|---|---|---|
| 循环 0~4 | for(int i=0;i<5;i++) | for i in range(5) | range 终点取不到 |
| 循环 1~5 | for(int i=1;i<=5;i++) | for i in range(1,6) | 很多人忘记 + 1 |
| 倒序 5~1 | for(int i=5;i>=1;i--) | for i in range(5,0,-1) | 结束写 0,不是 1 |
| 遍历数组元素 | for(auto x:a) | for x in lst: | Python 不用下标 |
| 循环 n 次不用 i | for(int i=0;i<n;i++) | for _ in range(n) | _只是约定,不是关键字 |
#include <iostream>using namespace std;int main(){ int n; cin >> n; //输入 for(int i=0;i<n;i++){ for(int j=0;j<n;j++){ cout << i*j << " "; } cout << endl; //换行 } return 0;}end=" ":print 默认会换行,end=" "改成用空格隔开,不换行
# 1. 输入:读取一个整数nn = int(input())
# 2. 嵌套循环,n行n列for i in range(n): for j in range(n): print(i*j, end=" ") print()py的字符串是不可变的(阴间)
操作先转列表,再转字符串
# 1.输入一串字符s = input("请输入一串字符:")# 2.转为列表,每个字符单独放进去lst = list(s)
# ==========中间操作在这里写==========# 举几个常见操作例子,你可以按需修改# 例1:把下标0的字符改成大写lst[0] = lst[0].upper()# 例2:反转整个字符列表lst.reverse()# 例3:删除第2个字符(下标1)# del lst[1]# ====================================
# 3.列表转回字符串result = ''.join(lst)print("处理后的字符串:", result)蓝桥杯py常用语法(面向小白,便于速成)_哔哩哔哩_bilibili
lis=list(map(int,input().split()))
print(lis)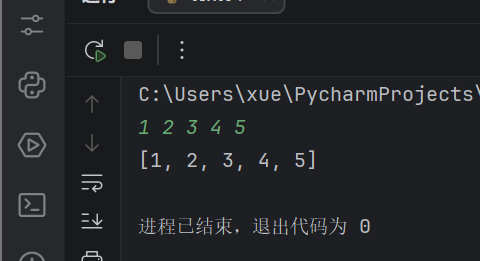
[P16235 蓝桥杯 2026 省 B] 蓝桥竞技 - 洛谷
t = int(input())
for _ in range(t):
n = int(input())
a=list(map(int,input().split()))
total=sum(a)
if(total%5!=0): #print(" 该轮失败: total ") print("F") continue
k=total//5 flag=True
print(k)
for num in a: if num>k: flag=False print(" 该轮失败: k ") print(num) break
print("T" if flag else "F")# 列表字符串s=list(input().strip())print(s)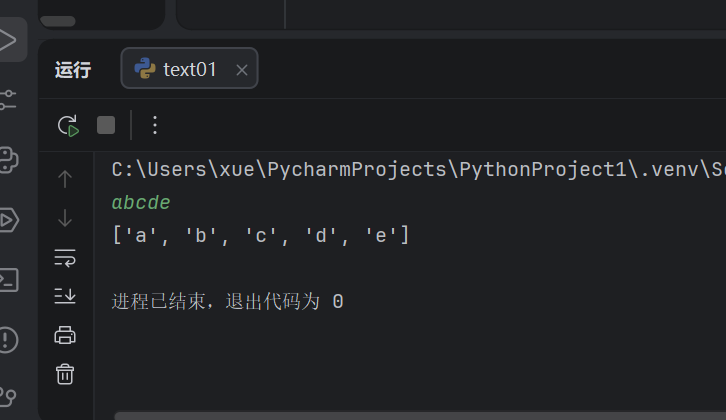
# 创建分配列表lis=[0]*100# 创造n行m列lit = [[0 for i in range(m)] for j in range(n)]
lit = [[0 for _ in range(m)] for _ in range(n)]
lit = [[0] * m for _ in range(n)]#这是**列表推导式**,一次性生成包含 2 个列表的二维列表(2 行网格),等价于下面完整循环写法:grid = [list(input().strip()) for _ in range(2)]
# 列表叠加器创造列表lit=[[0 for i in range(3)] for j in range(3)]lit[1][1]=1print(lit)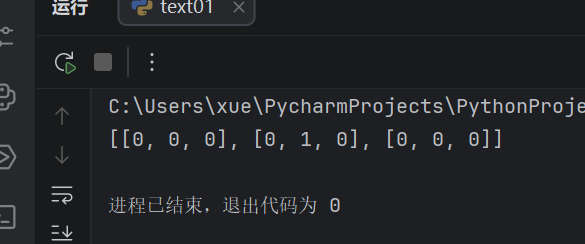
import sys
input = sys.stdin.readline
# 读取 n 和 mn, m = map(int, input().split())
# 读取 n 个字符串 S 一行一行读s = [input().strip() for _ in range(n)]
# 读取 m 个字符串 Tt = [input().strip() for _ in range(m)]
print(s)print(t)# 创建分配列表lis=[1]*6
# 列表叠加器创造列表lit=[[0 for i in range(3)] for j in range(3)]lit[1][1]=1print(lit)
# 以空格为分格符print(" ".join(map(str,lit)))print(*lit)print(*lis)print(" ".join(map(str,lis)))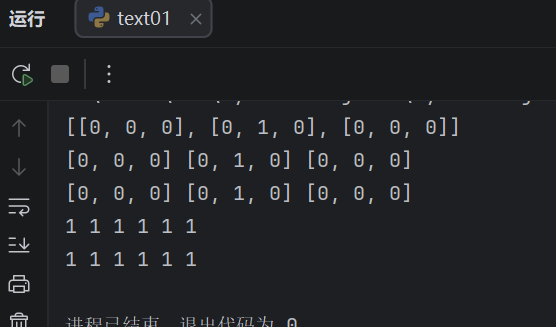
a=1.229178b=0
print(f"{a:.2f}")print(f"{b:.3f}")print(round(a,2))print(round(b,2))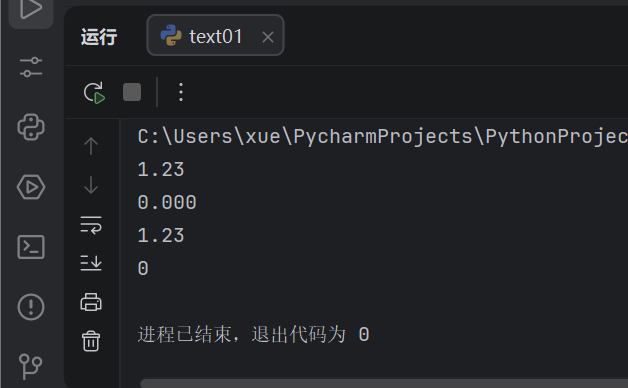
s.find(sub, start=0, end=len(s))sub 在字符串s中第一次出现的下标start起始位置,end终止位置(左闭右开)python
运行
"abcabc".find("bc") # 1"abcabc".find("xx") # -1s.index(sub, start=0, end=len(s))find几乎一样,查找子串第一次出现下标python
运行
"abcabc".index("bc") # 1"abcabc".index("xx") # ValueError: substring not found一句话区分 find vs index:找不到时,find 返回 - 1,index 报错
s.count(sub, start=0, end=len(s))sub在指定区间不重叠出现的次数python
运行
"aaaa".count("aa") # 2 (位置0、2,不会重叠计数)Python 字符串底层是朴素匹配(没有 KMP,CPython 实现)
设主串长度 n,子串长度 m
表格
| 方法 | 时间复杂度 | 说明 |
|---|---|---|
find() | (O(n\cdot m)) | 最坏情况逐位置比对 |
index() | (O(n\cdot m)) | 和 find 底层代码几乎一样,仅异常处理不同 |
count() | (O(n\cdot m)) | 遍历整串,每次尝试匹配子串 |
补充:
- 日常短字符串感受不出来差异;超大文本 + 长子串才会明显变慢
- 列表的
list.count():(O(n)),遍历一次列表逐个相等判断- 列表的
list.index():(O(n)),找到第一个匹配元素就停止⚠️ 列表没有 find ()!很多人容易混淆字符串和列表 API。
表格
| 函数 | 功能 | 未找到行为 | 复杂度 (字符串) | 复杂度 (列表) |
|---|---|---|---|---|
| find | 查找首次子串位置 | return -1 | (O(nm)) | 不存在 |
| index | 查找首次子串 / 元素位置 | 抛 ValueError | (O(nm)) | (O(n)) |
| count | 统计匹配次数 | 返回 0 |
s.add(x) # 添加元素,存在则无变化s.remove(x) # 删除元素,不存在抛KeyErrors.discard(x) # 删除元素,不存在不报错s.pop() # 随机删除一个元素并返回s.clear() # 清空集合
# 集合运算a & b # 交集 a.intersection(b)a | b # 并集 a.union(b)a - b # 差集 a.difference(b)a ^ b # 对称差集(只在其中一个里面的元素)判断元素 a 是否存在于集合中,存在返回 True,不存在返回 False
s = {1,2,3}print(2 in s) # Trueprint(5 in s) # FalseO(log(n))
返回最小值,py 里面只要小分堆,大分堆加负号使用
import heapqq=[]heapq.heappush(q,2)heapq.heappush(q,1)print(q)# 弹出并返回堆顶最小值,print(heapq.heappop(q))print(q)print(len(q))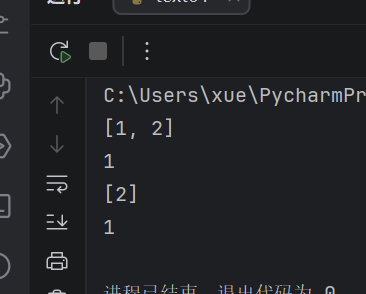
a=bin(3)print(a)print(a[2:])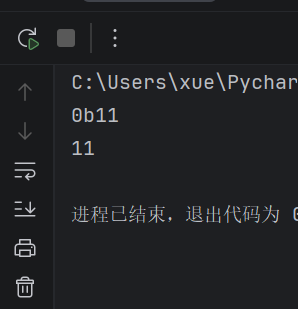
a=9lis=list(map(int,bin(a)[2:].zfill(10).strip()))print(lis)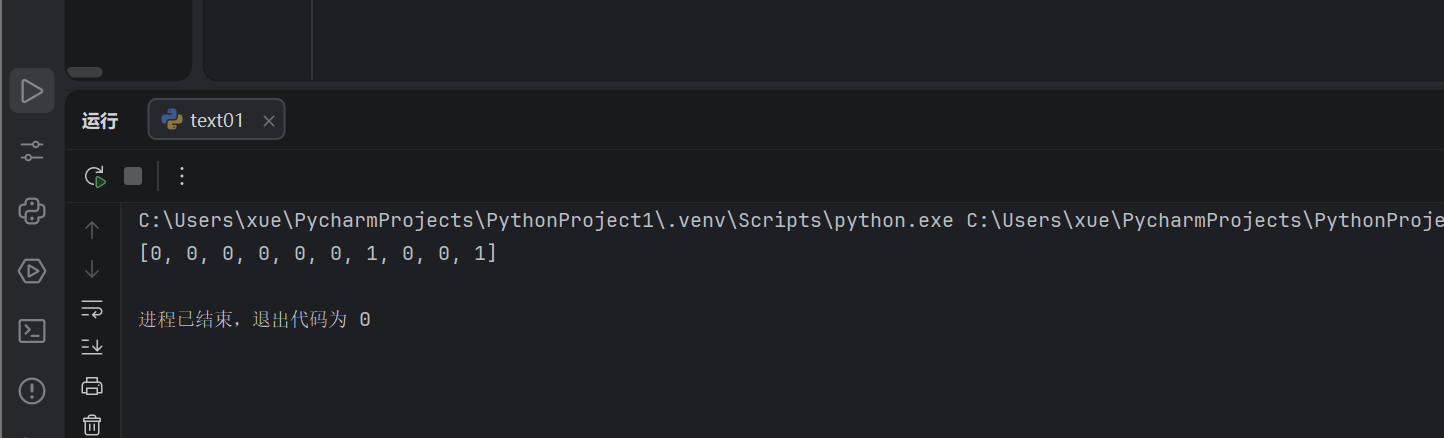
bin(a)bin() 把整数转二进制字符串,自带前缀 0b
python
运行
bin(9) # '0b1001'9 的二进制:(8+1 = 1001_2)
bin(a)[2:]切片从下标 2 开始,切掉前面的 0b
python
运行
bin(9)[2:] # '1001'.zfill(10)zfill(n):在字符串左侧补 0,让总长度等于 n
'1001' 长度是 4,左边补 6 个 0 →
python
运行
'1001'.zfill(10) # '0000001001'.strip()strip ():删除字符串首尾空白字符(空格、换行等)
这里字符串
'0000001001'首尾没有空格,strip 在这里等于没作用,多余代码
map(int, 字符串)字符串是'0000001001',遍历每一个字符,逐个转 int
'0'→0, '0'→0 ... '1'→1list(...)把 map 对象转为列表,得到最终:
python
运行
[0, 0, 0, 0, 0, 0, 1, 0, 0, 1]把数字 9 转为10 位定长二进制列表(高位补 0)
注意:
strip()在这里是无效冗余代码,可以删掉。
python
运行
a=9lis=list(map(int,bin(a)[2:].zfill(10)))print(lis)zfill 是左边补 0;rjust 也可以实现同样效果bin(a)[2:][::-1]lis=[1,3,2,4,5]lis.sort()print(lis)lis.sort(reverse=True)print(lis)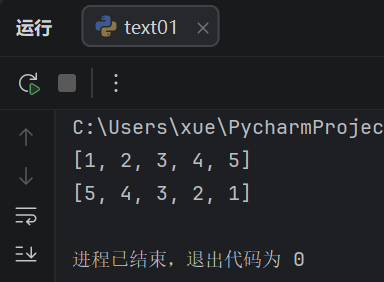
lis=[[1,2], [3,4], [7,1] ]# 根据第二个值对整个列表排序lis.sort(key=lambda x : x[1])print(lis)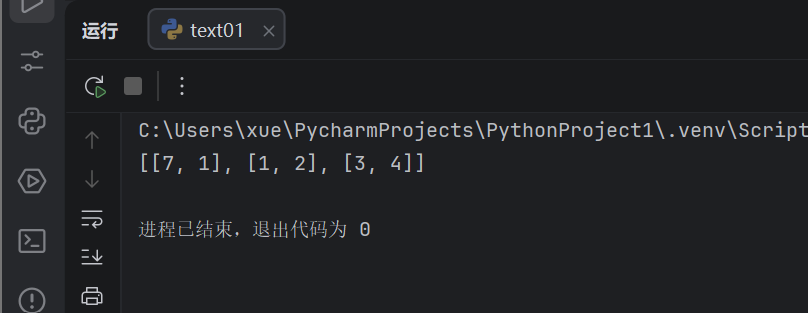
lis=[[1,2], [3,4], [7,4] ]# 先根据第二个值,再根据第一个值对整个列表排序lst.sort(key=lambda x: (x[1],x[0]))lis.sort(key=lambda x : (x[1],x[0]))print(lis)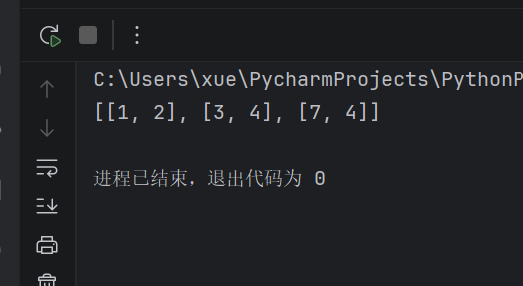
import sys
d = list(map(int, sys.stdin.buffer.read().split()))
n, k = d[0], d[1]a = d[2:]
def key(x): # 转成二进制字符串,例如 13 -> "1101" s = bin(x)[2:]
# 统计二进制中 1 的个数 cnt = s.count('1')
# 0 特殊处理 if x == 0: low = 31 else: # 从右往左查找第一个 1 # 位置从 0 开始 low = s[::-1].index('1')
# Python 会依次比较 cnt、low、x return cnt, low, x
a.sort(key=key)
print(a[k - 1])import bisect
lis=[1,2,4,3,5,4] # 查找第一个大于等于4的下标print(bisect.bisect_left(lis,4))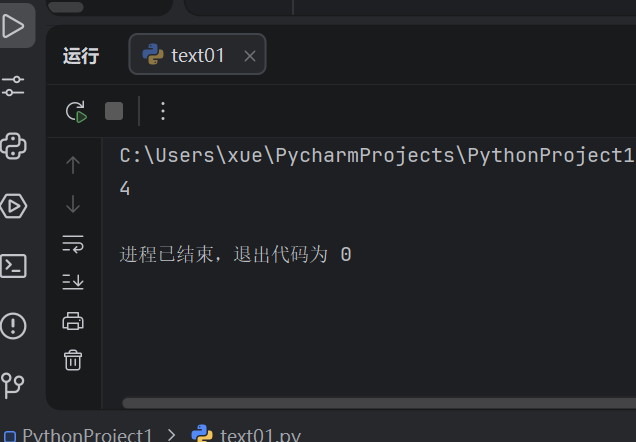
import bisect
lis=[1,5,4,3,5,4] # 查找第一个大于4的下标print(bisect.bisect_right(lis,4))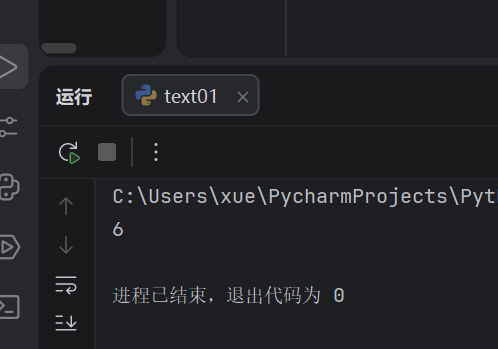
a="A"
print(ord(a))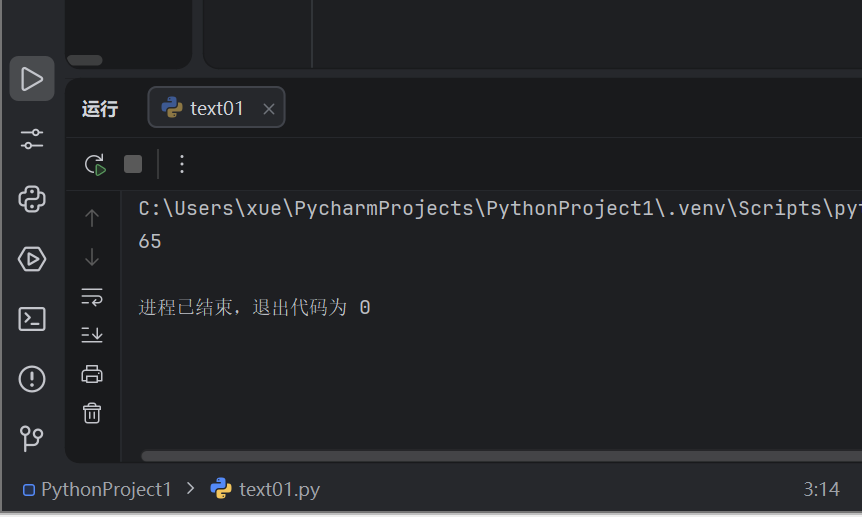
a=65
print(chr(a))
import sys
input = lambda: sys.stdin.readline().strip()
n = input()print(int(n, 16))bin(n)e.g
bin(16) # '0b10000'import math# 找最小公倍数print(math.gcd(4,6))
import math# kai'fprint(math.sqrt(4))
s[start:end:step]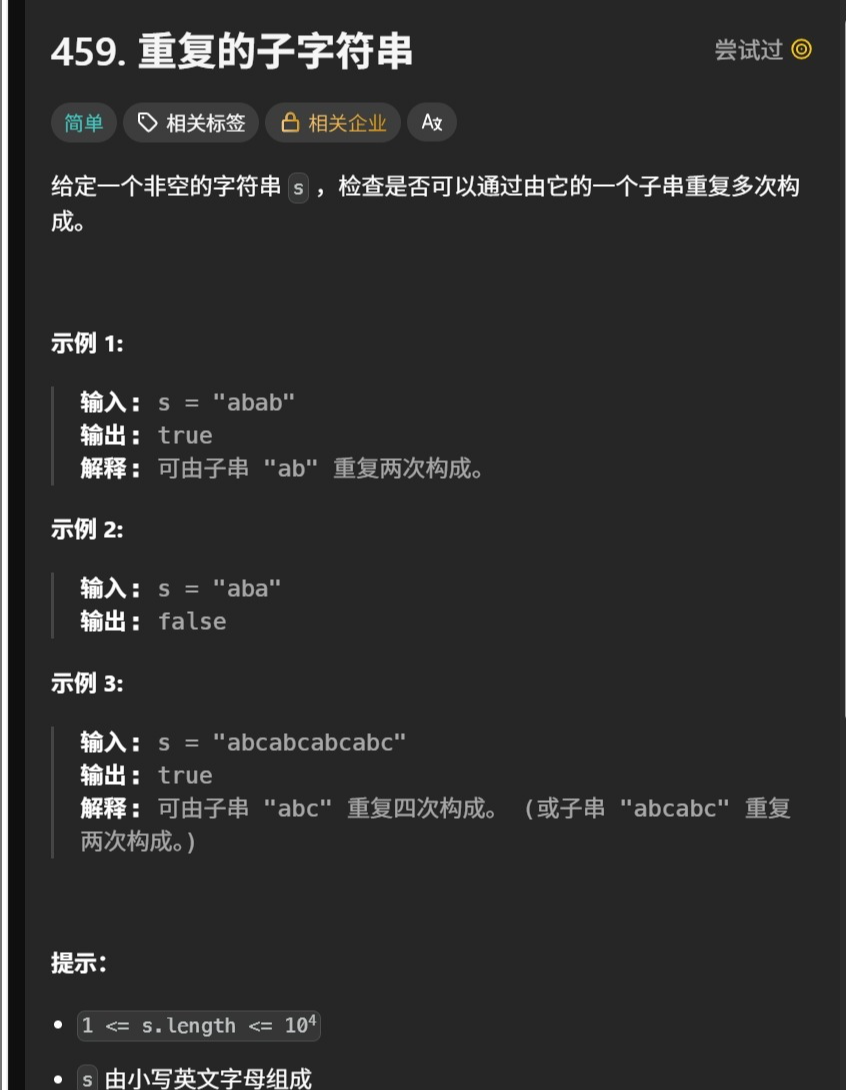
class Solution: def repeatedSubstringPattern(self, s: str) -> bool: # s拼接后去掉首尾 return s in (s+s)[1:-1][:-1] 是 Python 的切片写法,表示:
从开头开始,取到倒数第一个元素之前,不包含倒数第一个元素。
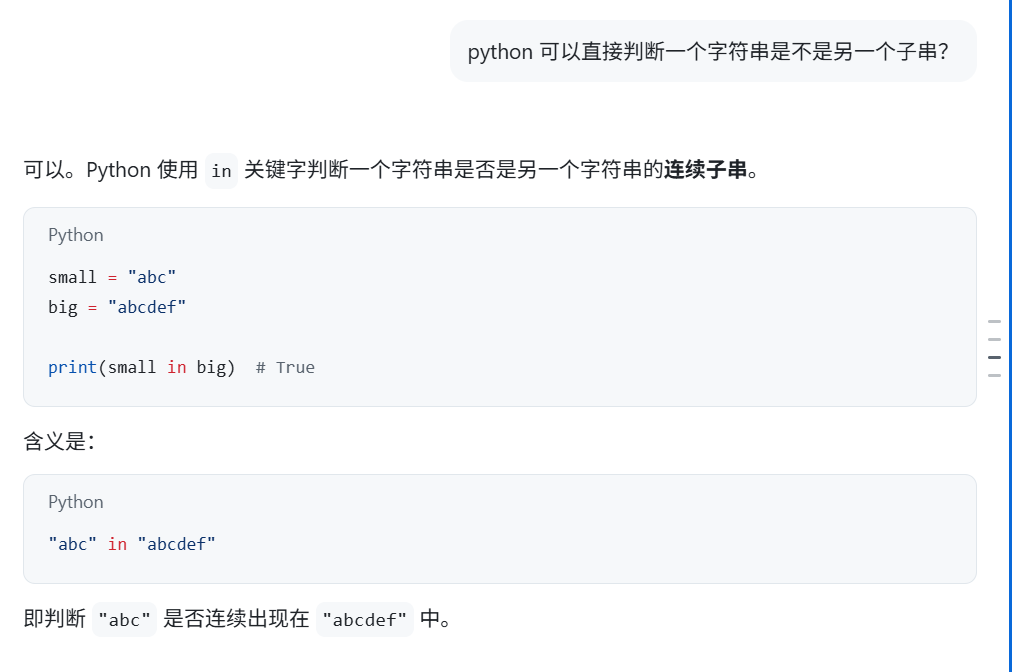
b=lst[::-1]库函数
#`isalnum()` 用于判断字符是否是:
- 英文字母- 数字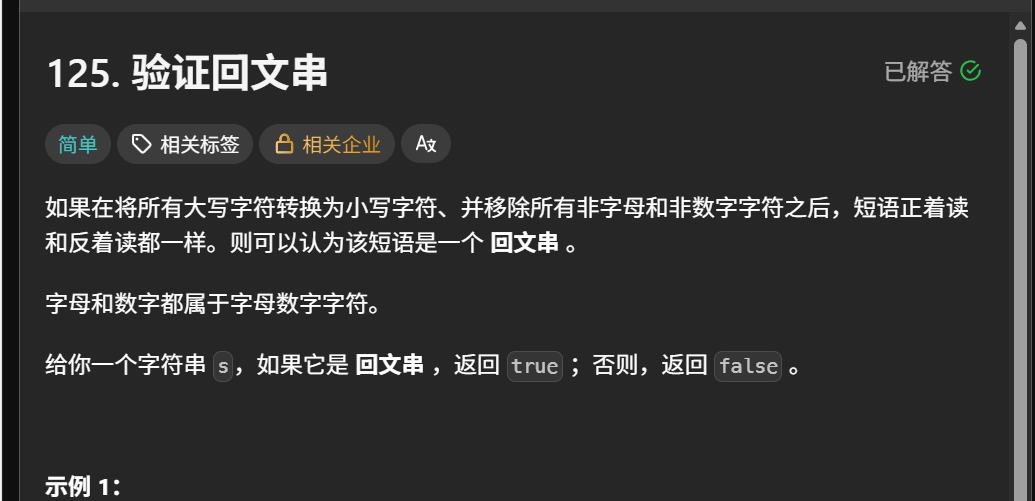
class Solution: def isPalindrome(self, s: str) -> bool: n=len(s) l=0 r=n-1 while(l<r): if not s[l].isalnum(): l+=1 elif not s[r].isalnum(): r-=1 elif(s[l].lower()==s[r].lower()): l+=1 r-=1 else: return False return True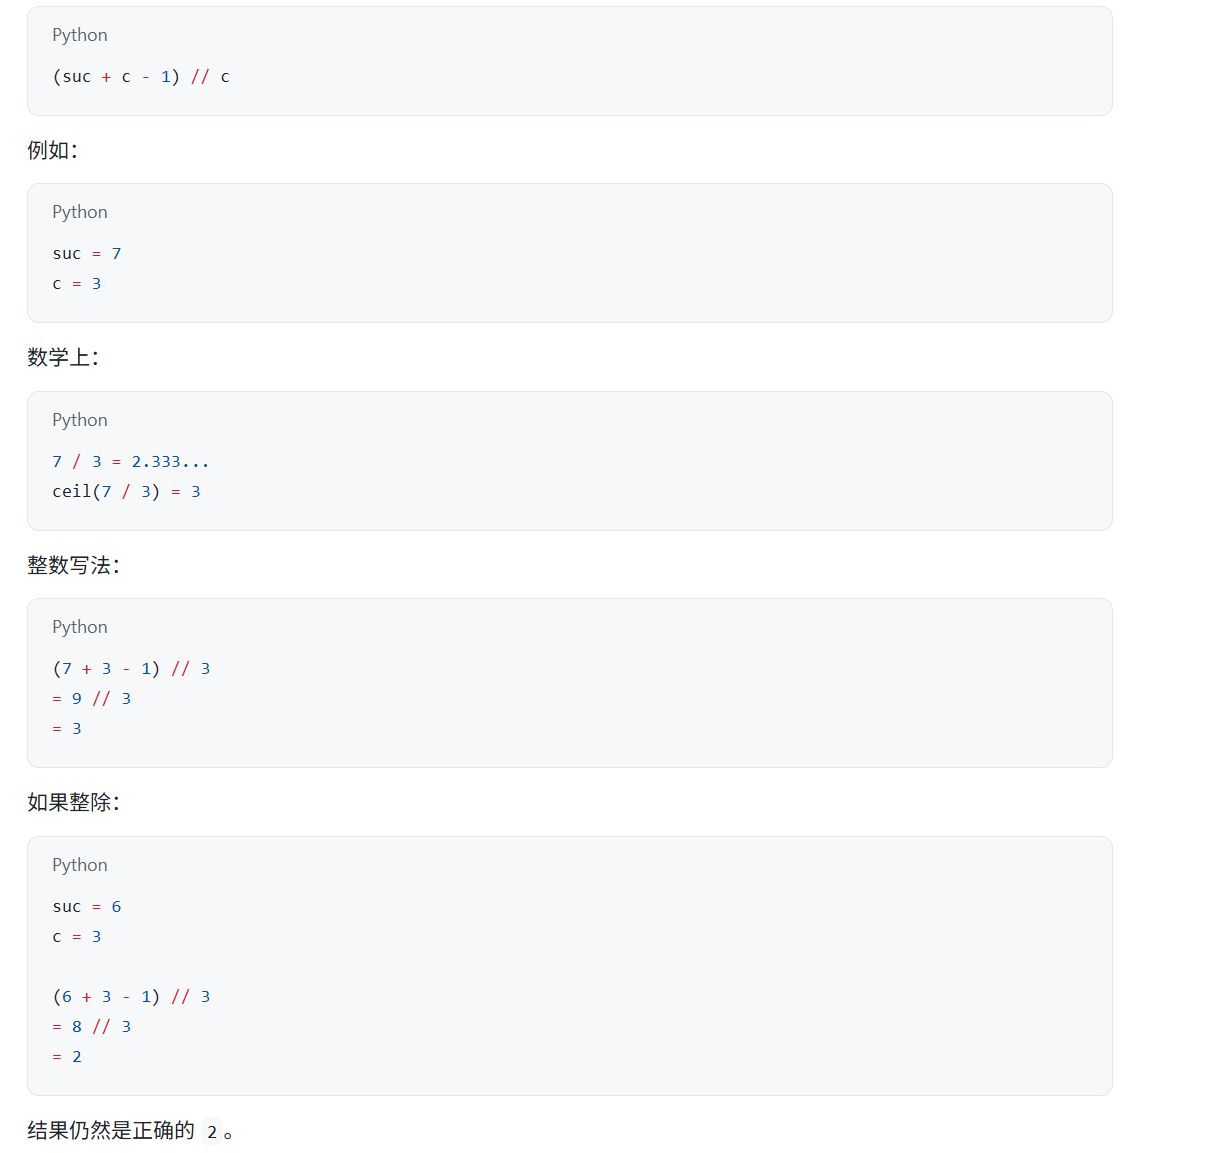
(suc+c-1)//c二分
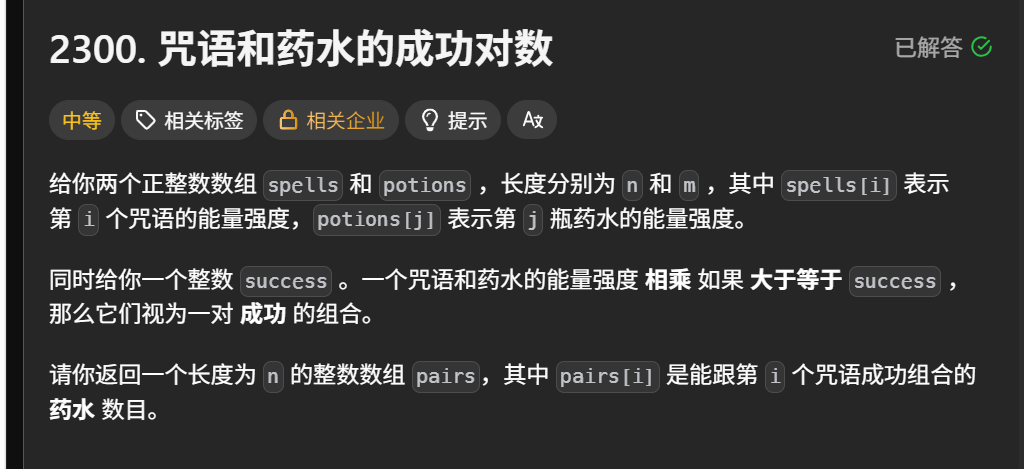
def lower_bound(pot: list[int], suc1: int) -> list[int]: l=0 r=len(pot)-1
while(l<=r): m=(l+r)//2 if(pot[m]>=suc1): r=m-1 else: l=m+1 return l
class Solution: def successfulPairs(self, spells: list[int], potions: list[int], suc: int) -> list[int]: pairs=[] potions.sort() for c in spells: #cnt=0 k1=(suc+c-1)//c st=lower_bound(potions,k1) pairs.append(len(potions)-st)
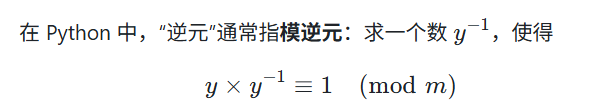
return(pairs)在 Python 中,“逆元”通常指模逆元:
直接使用:
Python
y = 3mod = 7
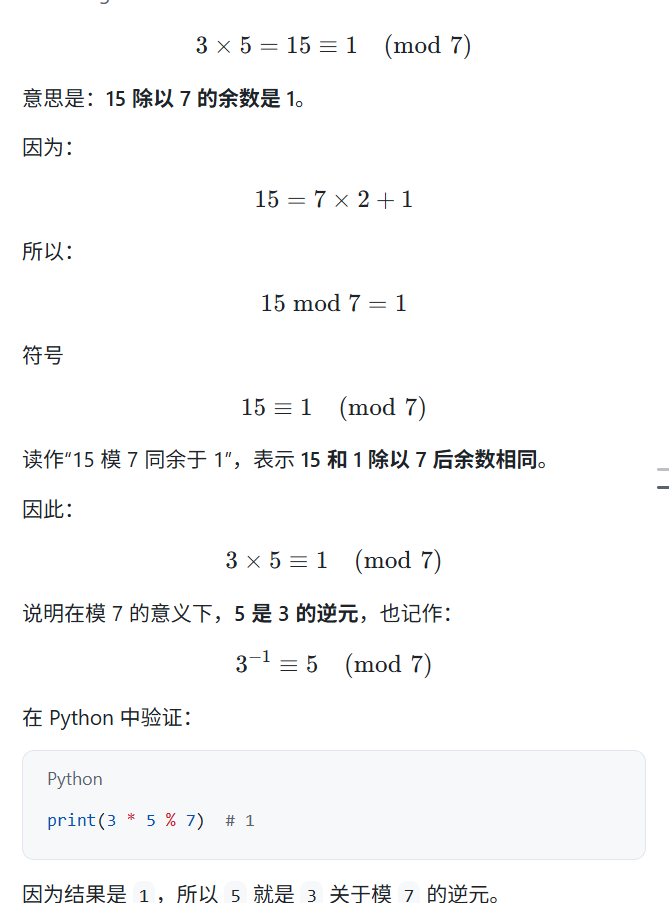
inv_y = pow(y, -1, mod)print(inv_y) # 5因为:
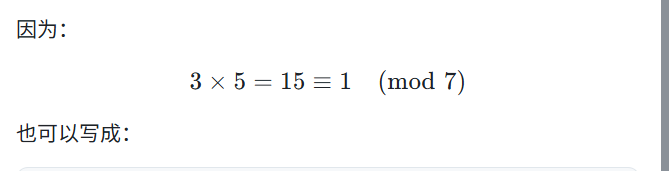
Python
y_inv = pow(y, -1, mod)注意:只有当 gcd(y, mod) == 1 时逆元存在,否则会报错。
Python
pow(2, -1, 4) # ValueError,因为 2 和 4 不互质如果模数是质数 MOD,根据费马小定理:
Python
inv_y = pow(y, MOD - 2, MOD)例如:
Python
MOD = 10**9 + 7y = 3
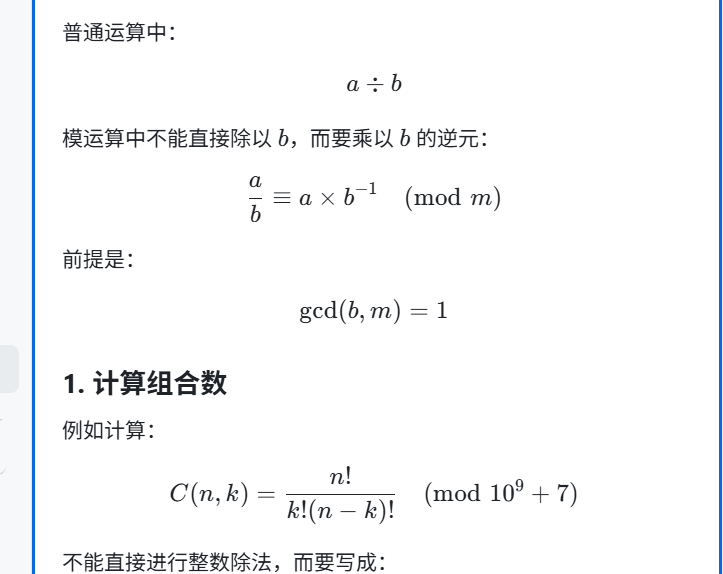
inv_y = pow(y, MOD - 2, MOD)模逆元的核心应用是:在模运算中实现“除法”。
MOD = 10**9 + 7
def combination(n, k): if k < 0 or k > n: return 0
fact = [1] * (n + 1)
for i in range(1, n + 1): fact[i] = fact[i - 1] * i % MOD
numerator = fact[n] denominator = fact[k] * fact[n - k] % MOD
# denominator 的逆元 denominator_inv = pow(denominator, MOD - 2, MOD)
return numerator * denominator_inv % MOD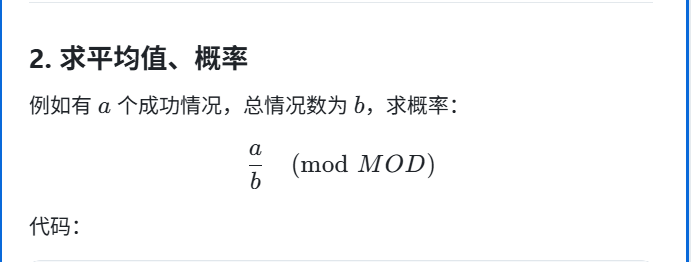
MOD = 10**9 + 7
def combination(n, k): if k < 0 or k > n: return 0
fact = [1] * (n + 1)
for i in range(1, n + 1): fact[i] = fact[i - 1] * i % MOD
numerator = fact[n] denominator = fact[k] * fact[n - k] % MOD
# denominator 的逆元 denominator_inv = pow(denominator, MOD - 2, MOD)
return numerator * denominator_inv % MOD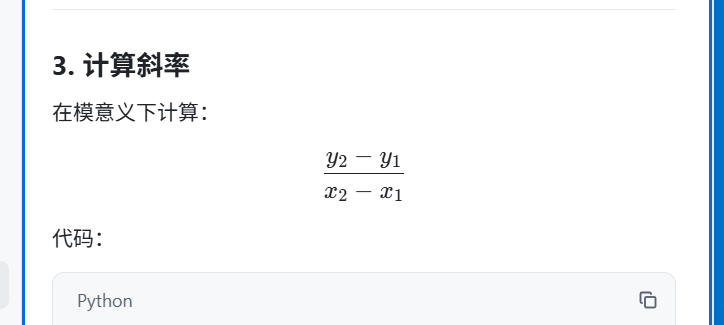
MOD = 10**9 + 7
x1, y1 = 1, 2x2, y2 = 4, 8
dy = (y2 - y1) % MODdx = (x2 - x1) % MOD
slope = dy * pow(dx, MOD - 2, MOD) % MOD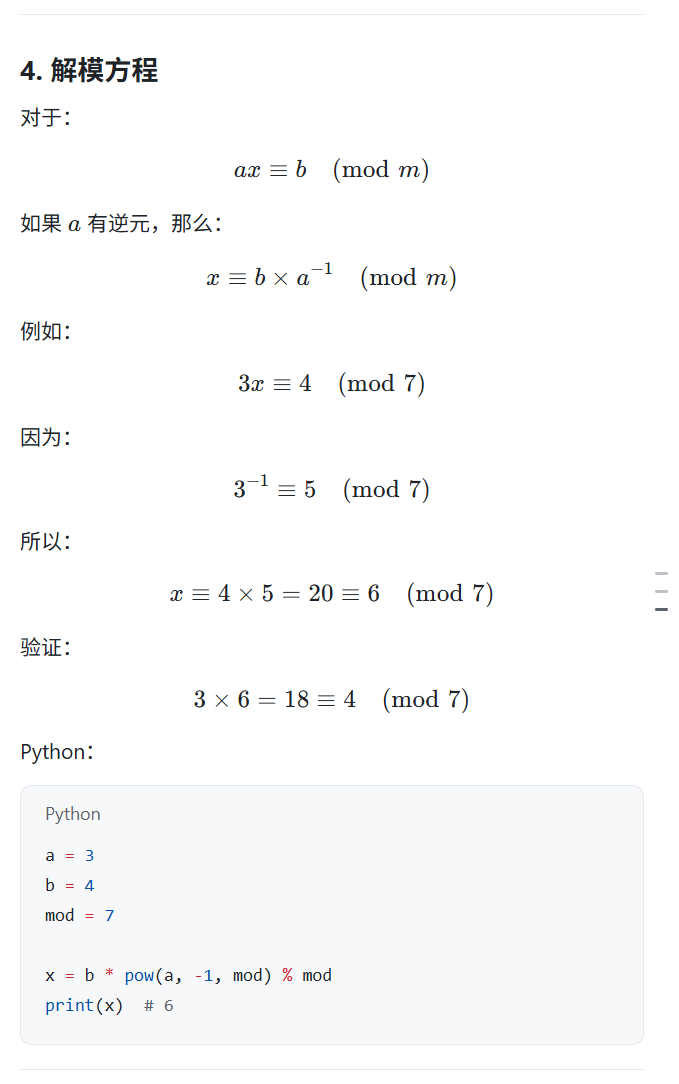
print(''.join(ans))表示:把列表 ans 中的所有字符串拼接起来,中间不添加任何字符,然后输出。
例如:
ans = ['a', 'b', 'c']print(''.join(ans))输出:
abc这里:
''是一个空字符串,表示拼接时不加分隔符。
如果写成:
print(' '.join(ans))则会在元素之间加空格:
ans = ['a', 'b', 'c']print(' '.join(ans))输出:
a b c如果写成:
print(','.join(ans))输出:
a,b,c在你前面的代码中:
ans = ['1', '3', 'a']print(''.join(ans))输出:
13a如果题目要求字符之间有空格,就使用:
print(' '.join(ans))输出:
1 3 aimport sys
input = sys.stdin.readline
def solve(): n = int(input()) s = input().strip()
r = []
p = s[0] c = 1
# 连续相同字符压缩 for i in range(1, n): if s[i] == p: c += 1 else: r.append(p + str(c)) p = s[i] c = 1
r.append(p + str(c)) r1=''.join(r) # 统计压缩后字符串中每个字符出现的次数 cnt = {} for ch in r1: cnt[ch]=cnt.get(ch,0)+1
mx = max(cnt.values())
# sorted 默认按照 ASCII 码从小到大排序 ans = []
for ch in sorted(cnt): if cnt[ch] == mx: print(ch,end=' ')
if __name__ == "__main__": solve()import sysimport mathimport bisectimport heapqfrom collections import deque, Counter, defaultdict
#sys.set_int_max_str_digits(0)
input = sys.stdin.readline
INF = 10**18mod = 998244353
directions = [ (-1, 0), (1, 0), (0, -1), (0, 1),]
X4 = [1, 0, -1, 0]Y4 = [0, 1, 0, -1]
X8 = [0, 1, 1, 1, 0, -1, -1, -1]Y8 = [1, 1, 0, -1, -1, -1, 0, 1]
Xh = [1, 2, 2, 1, -1, -2, -2, -1]Yh = [2, 1, -1, -2, -2, -1, 1, 2]
def solve(): n = int(input()) s=input().strip() s+=' ' st=[] l=1 for i in range(1,len(s)): if(s[i]==s[i-1]): l+=1 else: st.append(s[i-1]) st.append(str(l)) l=1 #print(''.join(st)) # 将列表拼接成完整压缩字符串 r = ''.join(st) cnt1=[0]*26 cnt2=[0]*10
for ch in r: if 'a'<=ch<='z': cnt1[ord(ch)-ord('a')]+=1 elif '0' <= ch <= '9': cnt2[ord(ch) - ord('0')] += 1
mx1=max(cnt1) mx2=max(cnt2) # print(mx1) # print(mx2) if(mx1==mx2): for i in range(10): if(cnt2[i]==mx2): print(chr(i+ord('0')),end=' ') for i in range(26): if(cnt1[i]==mx1): print(chr(i+ord('a')),end=' ') elif(mx1>mx2): for i in range(26): if(cnt1[i]==mx1): print(chr(i+ord('a')),end=' ') else: for i in range(10): if(cnt2[i]==mx2): print(chr(i+ord('0')),end=' ')
if __name__ == "__main__": solve()
""" @@@ @ @ @ @@ @ @@ @@@ @ @ @ @ @ @@@ @@ @@ @@ @ @@@ @ @ @ @ @ @ @ @ @ @@ @@ @@ @@ @ @ @ @ @ @ @ @ @ @@ @ @ @ @@ @@ @ @ @@@ @ @ @@@ @ @ @ @ @ @ @ @ @ @@ @@@@ @ @ @ @ @ @ @ @ @ @ @ @ @ @@ @ @ @@@ @ @ @ @ @ @ @ @ @ @ @ @ @@@ @ @ @ @ @@ @ @ @ @ @ @ @ @ @ @ @ @@@@@@@@ @ @@ @ @ @ @ @ @@ @ @ @ @ @ @@ @ @ @ @ @ @ @ @@@@@ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @@ @@@@@@@@ @ @ @ @ @ @ @ @@ @ @ @ @ @ @ @ @ @@@@ @ @@ @ @ @@@ @ @ @ @ @@ @ @ @ @ @ @ @ @ @@ @ @ @ @ @ @ @ @ @ @@ @@ @ @ @ @ @@ @ @@@ @ @ @ @@ @ @ @ @ @ @ @ @ @@ @ @ @ @ @ @@ @ @@@ @ @ @ @ @@@@@@@@@@@ @ @ @ @ @ @ @@ @ @ @ @ @ @@ @ @ @ @ @ @ @ @ @@@ @ @@ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @@@ @ @ @ @ @ @ @@@@ @ @ @ @ @ @@@@@@@@@ @ @ @ @@ @ @ @ @ @ @ @ @ @ @@ @ @ @ @ @ @@ @ @ @ @ @ @ @ @@ @ @@ @ @ @ @ @ @ @ @ @ @ @ @@ @ @ @@@ @ @ @ @@ @ @ @@ @ @@ @ @ @ @ @ @ @ @ @ @ @ @ @ @@ @ @ @ @ @ @ @@ @@ @ @ @ @ @ @ @ @ @ @ @@ @ @@ @@ @ @ @ @ @ @@ @ @ @@ @@ @ @ @ @ @ @ @ @ @ @ @ @ @ @ @@ @@@@@ @ @ @ @@ @@@@ @@ @ @@ @ @ @ @ @ @ @ @@ @ @ @@ @ @ @@@ @ @ @@ @ @@ @@ @ @ @ @ @ @ @@@ @ @ @@ @ @ @ @ @@ @ @ @ @ @ @ @ @ @ @ @ @@ @ @ @ @@ @ @ @@ @ @@@@@ @@ @ @ @ @ @ @@ @ @ @ @ @ @ @@@ @ @ @ @ @ @@ @@ @ @ @@@ @ @ @@ @ @ @ @ @ @ @ @ @ @ @ @@ @ @ @ @ @@ @ @ @ @ @ @ @ @ @@@ @@ @ @ @ @ @ @@ @@@ @ @ @@ @ @ @@@ @ @ @ @ @ @ @ @ @ @ @ @@@@ @@ @ @ @ @ @ @ @ @ @ @ @@@@ @@ @@ @@@ @ @ @ @ @ @ @ @@ @ @@ @ @ @ @ @ @ @ @ @ @ @ @ @@@@@@@@ @@@ @ @ @ @ @ @ @@ @ @ @ @ @ @ @ @@ @@@@@@@@ @@@ @ @ @ @ @@ @@ @ @ @ @ @ @ @ @@ @@@@@@ @ @ @ @ @ @@ @ @ @ @ @ @ @ @ @@@ @ @ @@ @ @ @@ @ @ @ @ @ @@ @ @@ @ @ @ @ @ @@ @ @@ @ @ @ @ @@ @@ @@@ @ @@@@@ @ @@ @@@@ @@@@ @@ @ @ @@ @ @ @@ @@ @ @@ @ @ @ @@ @@ @@ @ @ @@@ @@@@ @@ @ @ @ @@ @@ @@@ @ @ @@ @@ @@ @@ @ @ @ @@@@ @ @ @@@@@ @@ @ @ @ @ @@@@ @@ @ @ @ @ @@ @ @@@@ @ @ @ @@ @ @@ @ @ @ @@@ @@ @ @@ @ @ @ @ @ @ @ @ @@ @ @ @ @ @ @@ @ @ @@ @ @@@"""增减性单调的情况
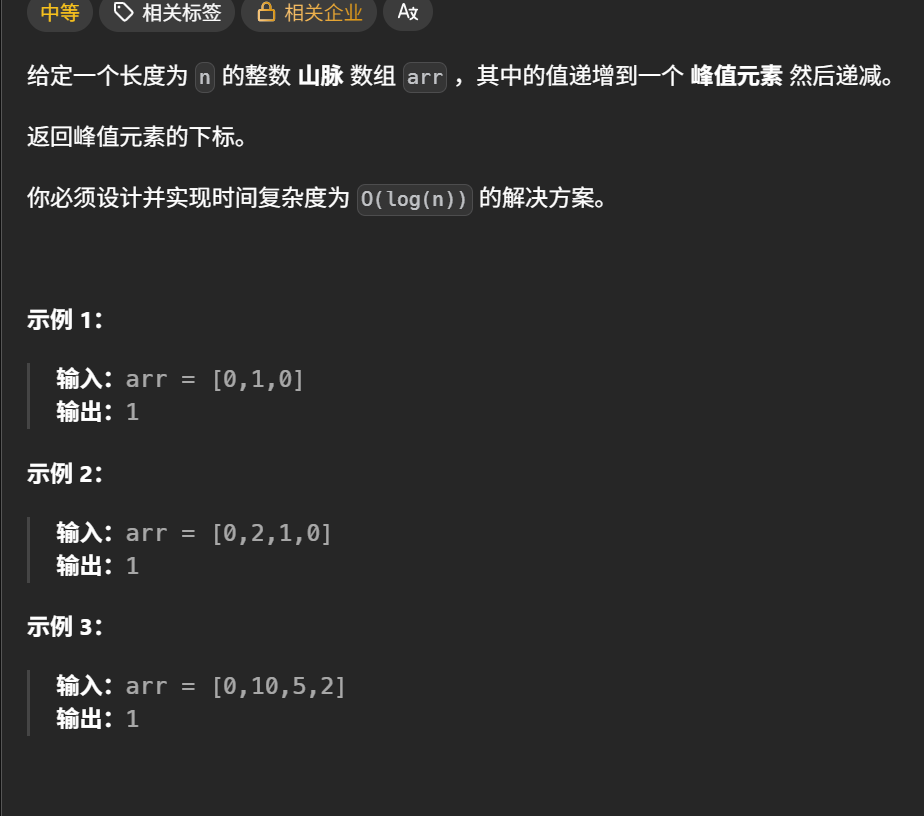
class Solution: def peakIndexInMountainArray(self, arr: List[int]) -> int: l=0 r=len(arr)-1 mid=0 while(l<r): mid=(l+r)//2 if(arr[mid-1]<arr[mid] and arr[mid]>arr[mid+1]): break #下降段:mid可能就是r elif(arr[mid]>arr[mid+1]): r=mid #上升段:mid一定不是l elif(arr[mid]<arr[mid+1]): l=mid+1 return midclass Solution: def peakIndexInMountainArray(self, arr: List[int]) -> int: l=0 r=len(arr)-2 while(l<=r): m=(l+r)//2 if(arr[m]<arr[m+1]): l=m+1 else: r=m-1 return l34. 在排序数组中查找元素的第一个和最后一个位置 - 力扣(LeetCode)
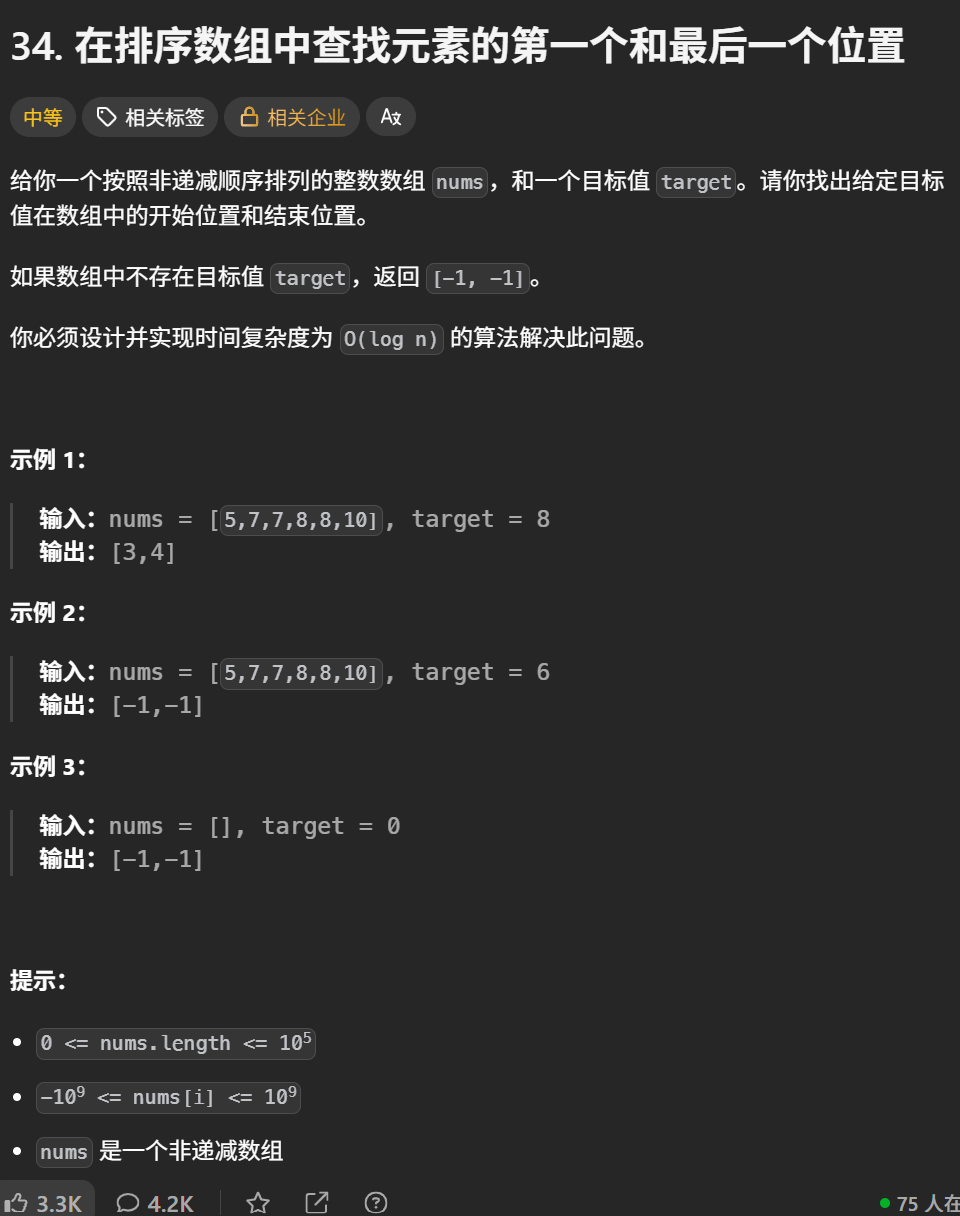
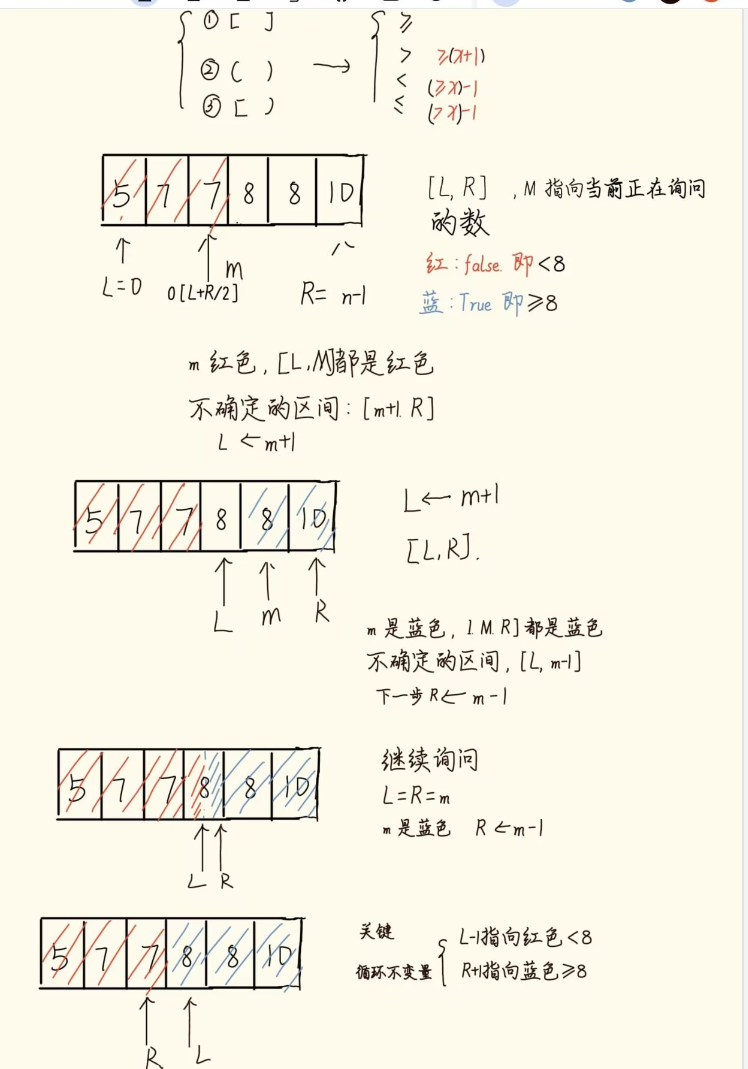
最后一个 ≤ x = 第一个 > x 的位置 - 1 最后一个 < x = 第一个 ≥ x 的位置 - 1
#[] 左右闭区间def lower_bound(nums: list[int], target: int) -> list[int]: l=0 n=len(nums) r=n-1 while(l<=r): #写在循环里面 m=(l+r)//2 if(nums[m]<target): l=m+1 else: r=m-1 return l
class Solution: def searchRange(self, nums: list[int], target: int) -> list[int]: start=lower_bound(nums,target) if(start>=len(nums) or nums[start]!=target): return [-1,-1] end=lower_bound(nums,target+1)-1 return [start,end]class Solution: # lower_bound 返回最小的满足 nums[i] >= target 的下标 i # 如果数组为空,或者所有数都 < target,则返回 len(nums) # 要求 nums 是非递减的,即 nums[i] <= nums[i + 1] def lower_bound(self, nums: List[int], target: int) -> int: left, right = 0, len(nums) - 1 # 闭区间 [left, right] while left <= right: # 区间不为空 # 循环不变量: # nums[left-1] < target # nums[right+1] >= target mid = (left + right) // 2 if nums[mid] >= target: right = mid - 1 # 范围缩小到 [left, mid-1] else: left = mid + 1 # 范围缩小到 [mid+1, right] # 循环结束后 left = right+1 # 此时 nums[left-1] < target 而 nums[left] = nums[right+1] >= target # 所以 left 就是第一个 >= target 的元素下标 return left
def searchRange(self, nums: List[int], target: int) -> List[int]: start = self.lower_bound(nums, target) if start == len(nums) or nums[start] != target: return [-1, -1] # nums 中没有 target # 如果 start 存在,那么 end 必定存在 end = self.lower_bound(nums, target + 1) - 1 return [start, end]
#[)左闭右开
class Solution: # lower_bound 返回最小的满足 nums[i] >= target 的下标 i # 如果数组为空,或者所有数都 < target,则返回 len(nums) # 要求 nums 是非递减的,即 nums[i] <= nums[i + 1] def lower_bound(self, nums: List[int], target: int) -> int: left, right = 0, len(nums) # 左闭右开区间 [left, right) # 有开区间不等于 while left < right: # 区间不为空 # 循环不变量: # nums[left-1] < target # nums[right] >= target mid = (left + right) // 2 if nums[mid] >= target: right = mid # 范围缩小到 [left, mid) else: left = mid + 1 # 范围缩小到 [mid+1, right) # 循环结束后 left = right # 此时 nums[left-1] < target 而 nums[left] = nums[right] >= target # 所以 left 就是第一个 >= target 的元素下标 return left
def searchRange(self, nums: List[int], target: int) -> List[int]: start = self.lower_bound(nums, target) # 选择其中一种写法即可 if start == len(nums) or nums[start] != target: return [-1, -1] # nums 中没有 target # 如果 start 存在,那么 end 必定存在 end = self.lower_bound(nums, target + 1) - 1 return [start, end]
#() 左右开区间class Solution: # lower_bound 返回最小的满足 nums[i] >= target 的下标 i # 如果数组为空,或者所有数都 < target,则返回 len(nums) # 要求 nums 是非递减的,即 nums[i] <= nums[i + 1] def lower_bound(self, nums: List[int], target: int) -> int: left, right = -1, len(nums) # 开区间 (left, right) while left + 1 < right: # 区间不为空 mid = (left + right) // 2 # 循环不变量: # nums[left] < target # nums[right] >= target if nums[mid] >= target: right = mid # 范围缩小到 (left, mid) else: left = mid # 范围缩小到 (mid, right) # 循环结束后 left+1 = right # 此时 nums[left] < target 而 nums[right] >= target # 所以 right 就是第一个 >= target 的元素下标 return right
def searchRange(self, nums: List[int], target: int) -> List[int]: start = self.lower_bound(nums, target) # 选择其中一种写法即可 if start == len(nums) or nums[start] != target: return [-1, -1] # nums 中没有 target # 如果 start 存在,那么 end 必定存在 end = self.lower_bound(nums, target + 1) - 1 return [start, end]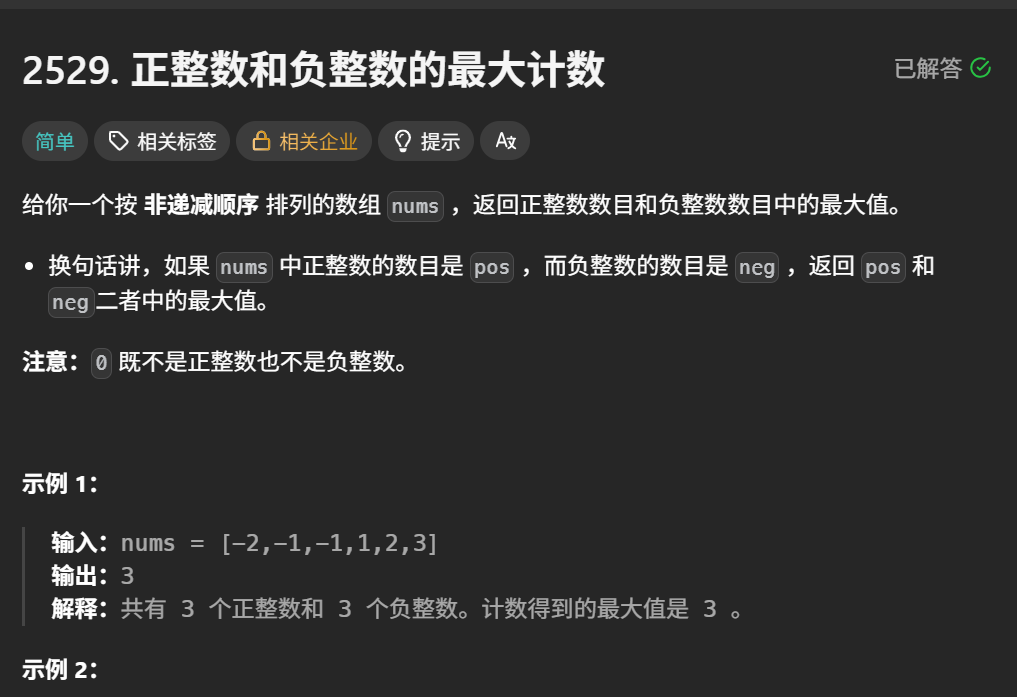
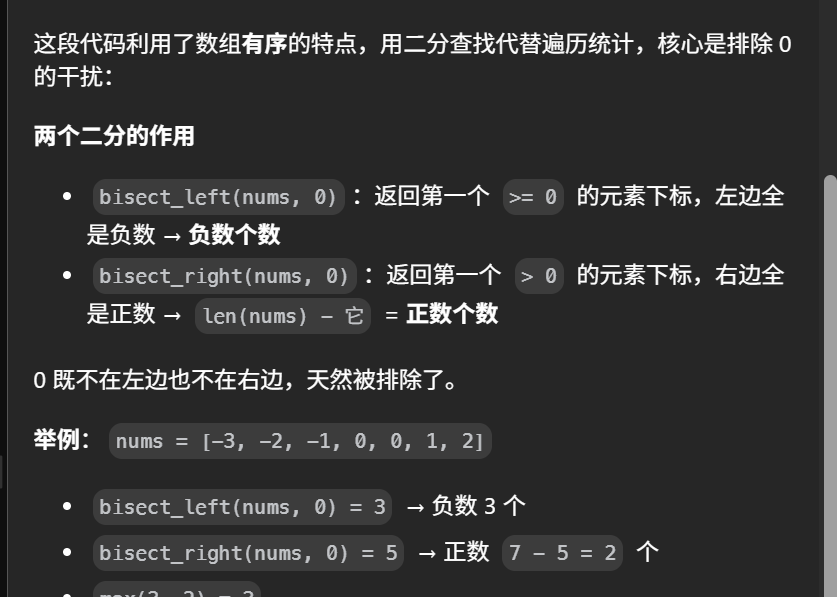
class Solution: def maximumCount(self, nums: List[int]) -> int: neg = bisect_left(nums, 0) pos = len(nums) - bisect_right(nums, 0) return max(neg, pos)
作者:灵茶山艾府链接:https://leetcode.cn/problems/maximum-count-of-positive-integer-and-negative-integer/solutions/2050916/mo-ni-by-endlesscheng-8e43/来源:力扣(LeetCode)著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。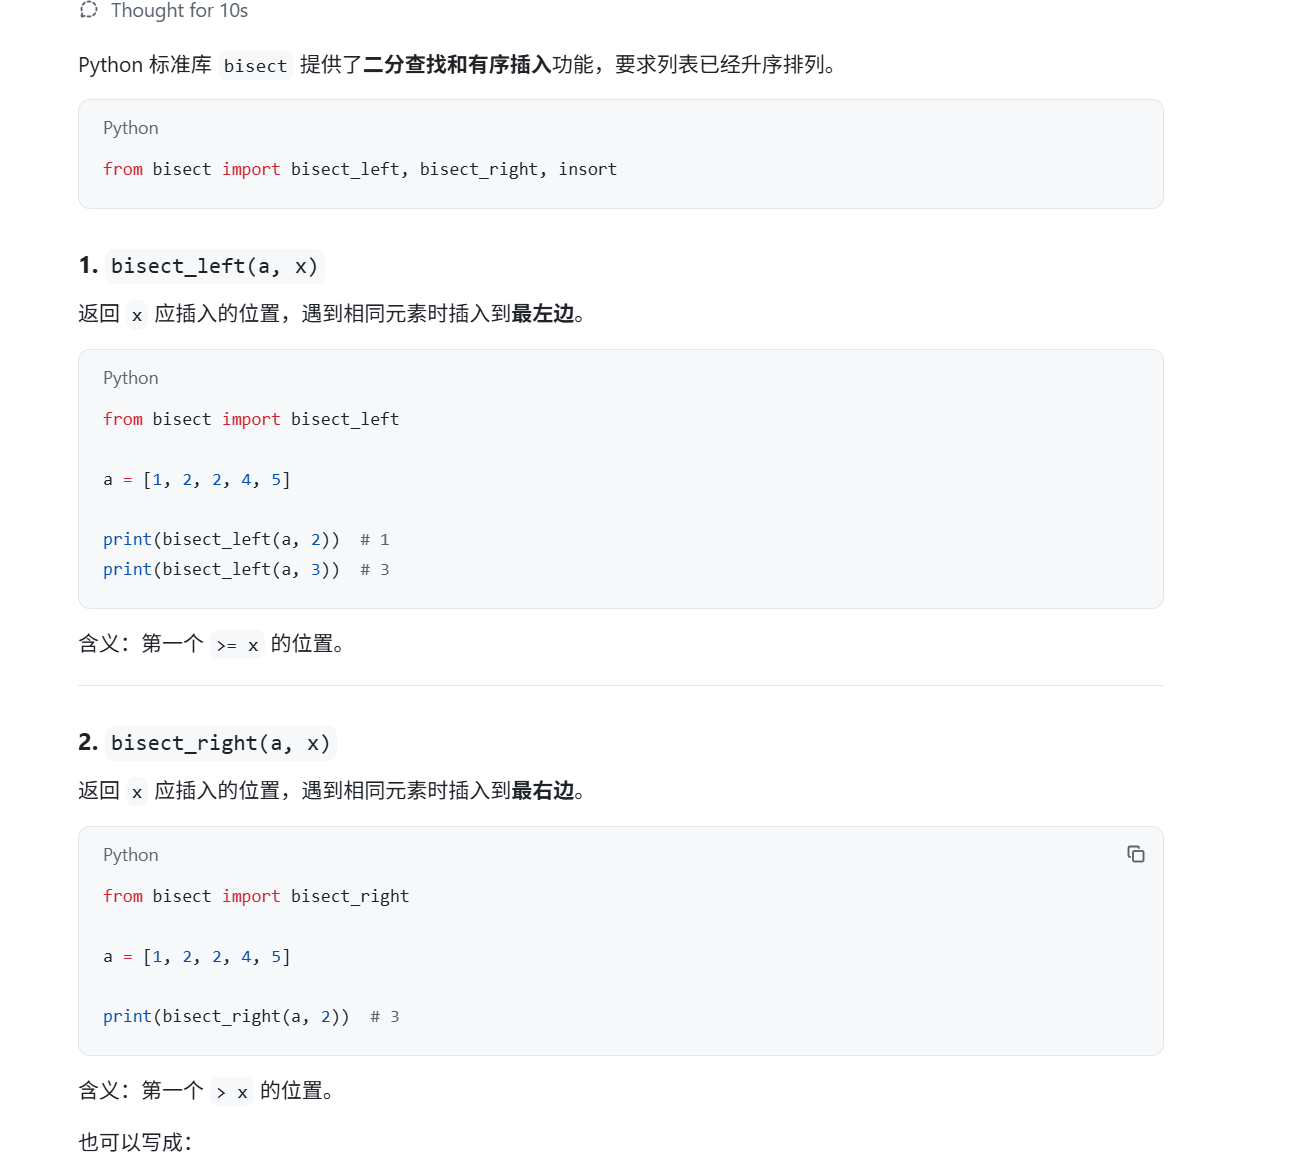
最重要的不是看到“两根指针”就套模板,而是证明:
为什么移动这个指针是安全的?被跳过的情况为什么不可能再成为答案?
这类双指针题目不能死记“固定左边”或“固定右边”,核心是看:
固定一个变量后,剩下两个变量是否具有单调性,能否用两个指针一次遍历完成
这不是双指针做法!
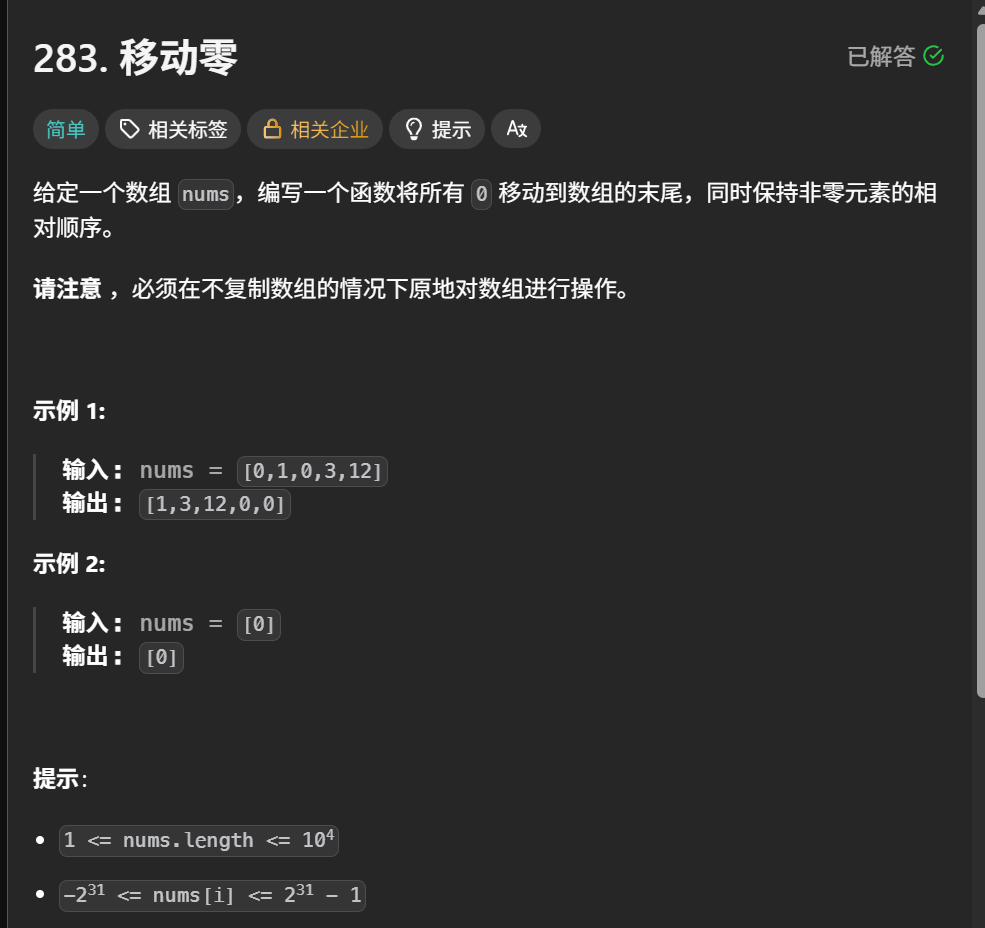
class Solution: def moveZeroes(self, nums: list[int]) -> None: """ Do not return anything, modify nums in-place instead. """ n=len(nums) k=0 for i in range(n): if(nums[i]!=0): nums[k]=nums[i] k+=1
for i in range(k,n): nums[i]=0双指针+快排做法
left指针指0
class Solution: def moveZeroes(self, nums: list[int]) -> None: """ Do not return anything, modify nums in-place instead. """ n=len(nums) left=right=0
while right<n: if(nums[right]!=0): nums[right],nums[left]=nums[left],nums[right] left+=1
right+=1167. 两数之和 II - 输入有序数组 - 力扣(LeetCode)
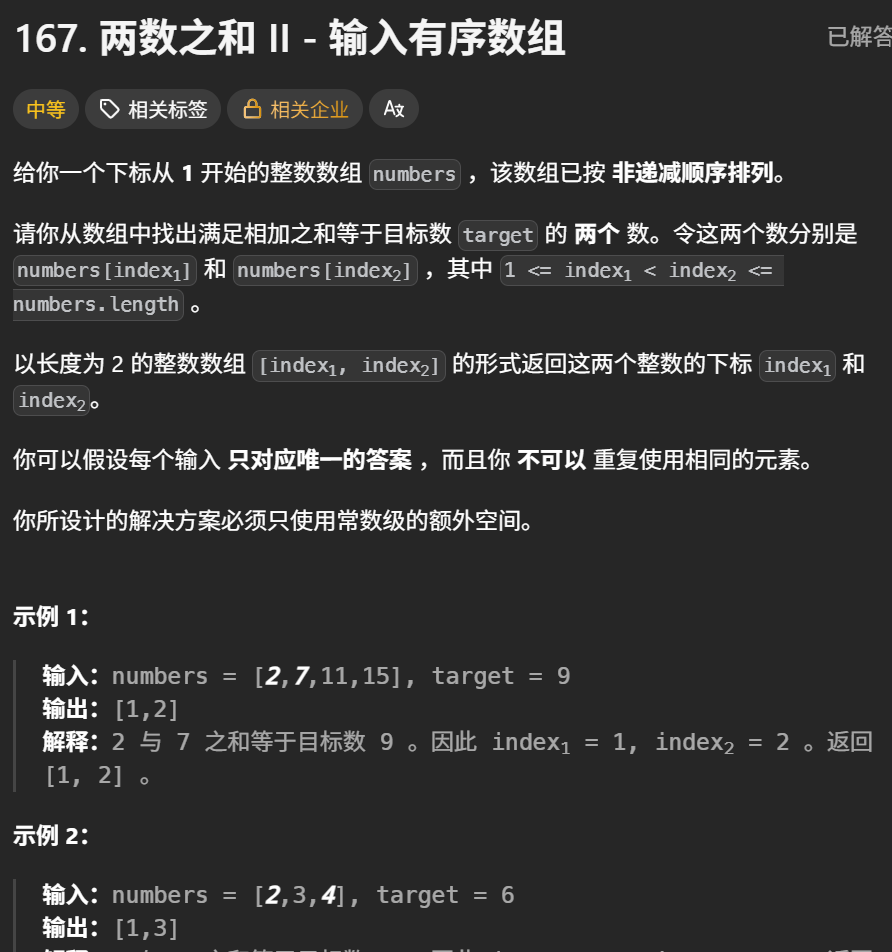
class Solution: def twoSum(self, nums: list[int], target: int) -> list[int]: nums.sort() left=0 right=len(nums)-1
while(left<right): lst=[] if(nums[left]+nums[right]==target): lst.append(left+1) lst.append(right+1) return lst elif(nums[left]+nums[right]>target): right-=1 else: left+=1三数之和
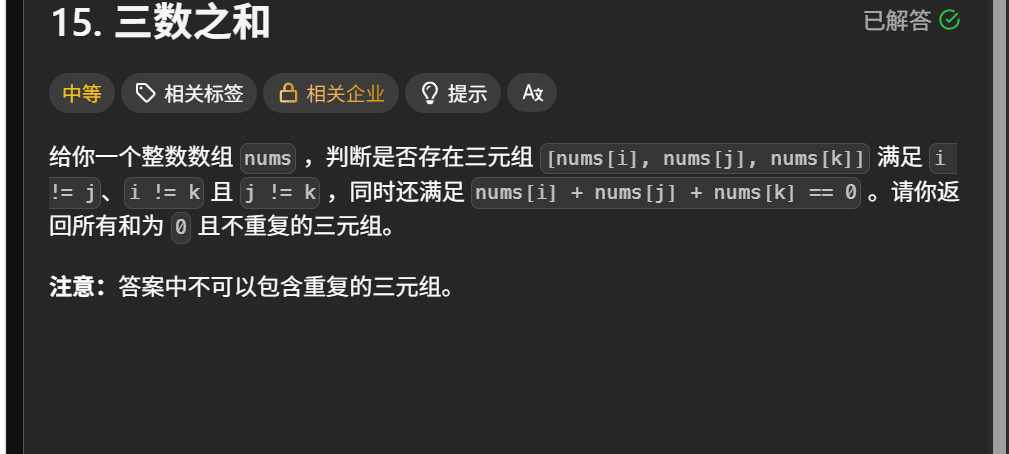
class Solution: def threeSum(self, nums: list[int]) -> list[list[int]]: nums.sort() res=[] n=len(nums) for i in range(0,n-2): x=nums[i]
j=i+1 k=n-1 if (i>0 and x==nums[i-1]): continue while(j<k): if(nums[i]+nums[j]+nums[k]>0): k-=1 elif(nums[i]+nums[j]+nums[k]<0): j+=1 else: res.append([nums[i],nums[j],nums[k]]) j+=1 while(j<k and nums[j]==nums[j-1]): j+=1 k-=1 while(k>j and nums[k]==nums[k+1]): k-=1
return res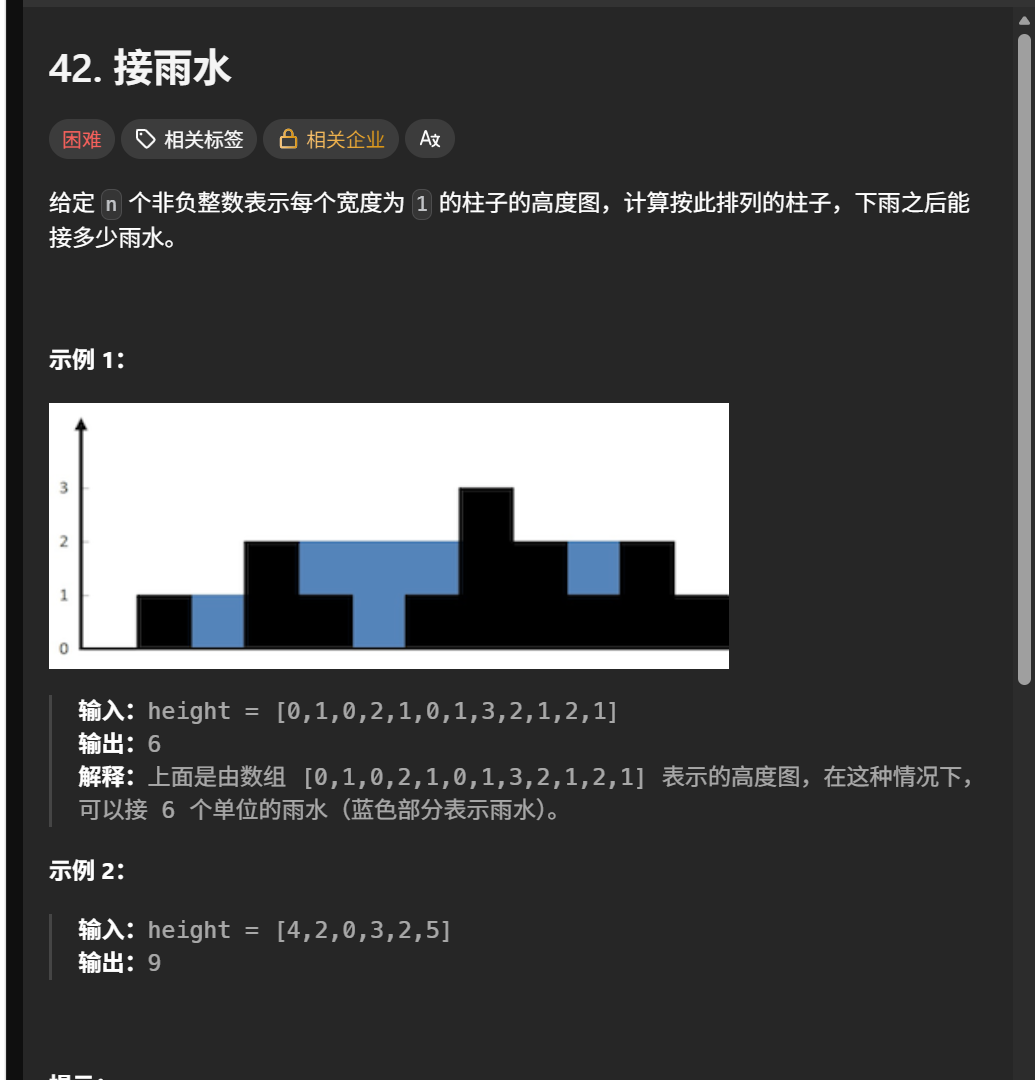
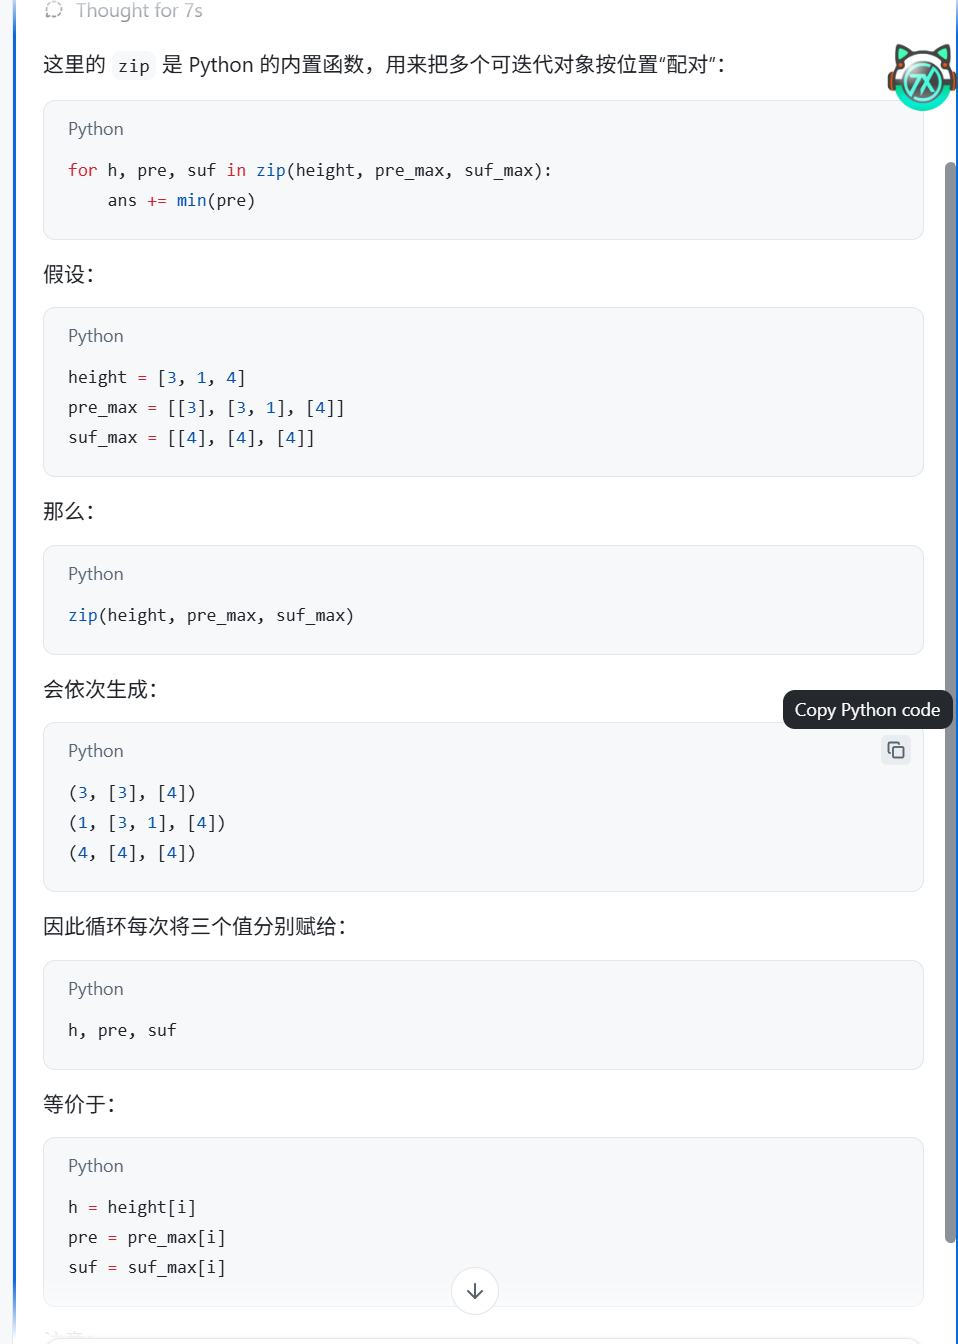
class Solution: def trap(self, height: list[int]) -> int: #由一段区间的较小部分决定,区间范围到下一个比初始大的结束 #怎么统计面积 # 前后缀 min(pre_max,suf_max)-helight->每单位木桶的水 ans=0 n=len(height)
pre_max=[0]*n suf_max=[0]*n
pre_max[0]=height[0] suf_max[-1]=height[-1]
for i in range(1,n): pre_max[i]=max(pre_max[i-1],height[i]) for i in range(n-2,-1,-1): suf_max[i]=max(suf_max[i+1],height[i]) for pre,suf,h in zip(pre_max,suf_max,height): ans+=min(pre,suf)-h return ans双指针
单调栈
enumerate() 用于遍历序列时同时获取下标和值
enumerate(iterable, start=0)iterable:可迭代对象,如列表、字符串、元组start:下标起始值,默认是 0items = ["apple", "banana", "orange"]
for index, value in enumerate(items): print(index, value)等价于
for index in range(len(items)): print(index, items[index])输出
0 apple1 banana2 orange转换成了列表
items = ["apple", "banana", "orange"]result=list(enumerate(items))print(result)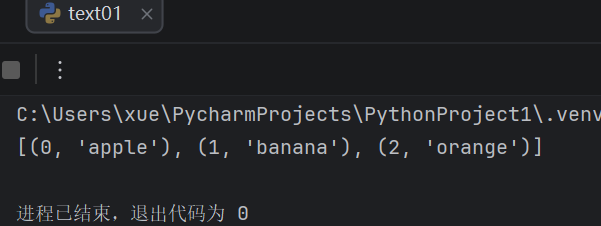
names = ["Tom", "Jerry", "Alice"]
for index, name in enumerate(names, start=1): print(index, name)输出
1 Tom2 Jerry3 Alicefor index, char in enumerate("Python"): print(index, char)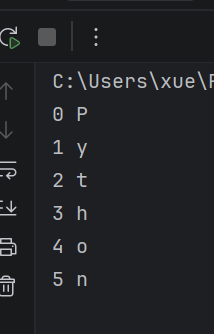
哈希法
class Solution: def twoSum(self, nums: List[int], target: int) -> List[int]: idx = {} # 创建一个空哈希表(字典) for j, x in enumerate(nums): # x=nums[j] #`in idx` 默认检查的是**字典的键** if target - x in idx: # 在左边找 nums[i],满足 nums[i]+x=target return [idx[target - x], j] # 返回两个数的下标 idx[x] = j # 保存 nums[j] 和 j #放在判断后,防止自己和自己配对
作者:灵茶山艾府链接:https://leetcode.cn/problems/two-sum/solutions/2326193/dong-hua-cong-liang-shu-zhi-he-zhong-wo-0yvmj/来源:力扣(LeetCode)著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。collections 模块中的一个计数器,本质上是字典的子类,专门用来统计元素出现次数。
from collections import Counter
nums = [1, 2, 1, 3, 2, 1]
count = Counter(nums)
print(count)输出
Counter({1: 3, 2: 2, 3: 1})1 出现 3 次2 出现 2 次3 出现 1 次统计字符串的字符
from collections import Counter
s = "hello"
count = Counter(s)
print(count)cnt.items() 是什么
先回顾:cnt = Counter(st) Counter 是 collections 里的计数容器,本质是字典(dict)的子类:
👉 cnt.items() 返回一个可迭代对象,里面每一项是 (key, value) 二元组 格式:(单词, 出现次数)
#访问:for i ,x in cnt.items():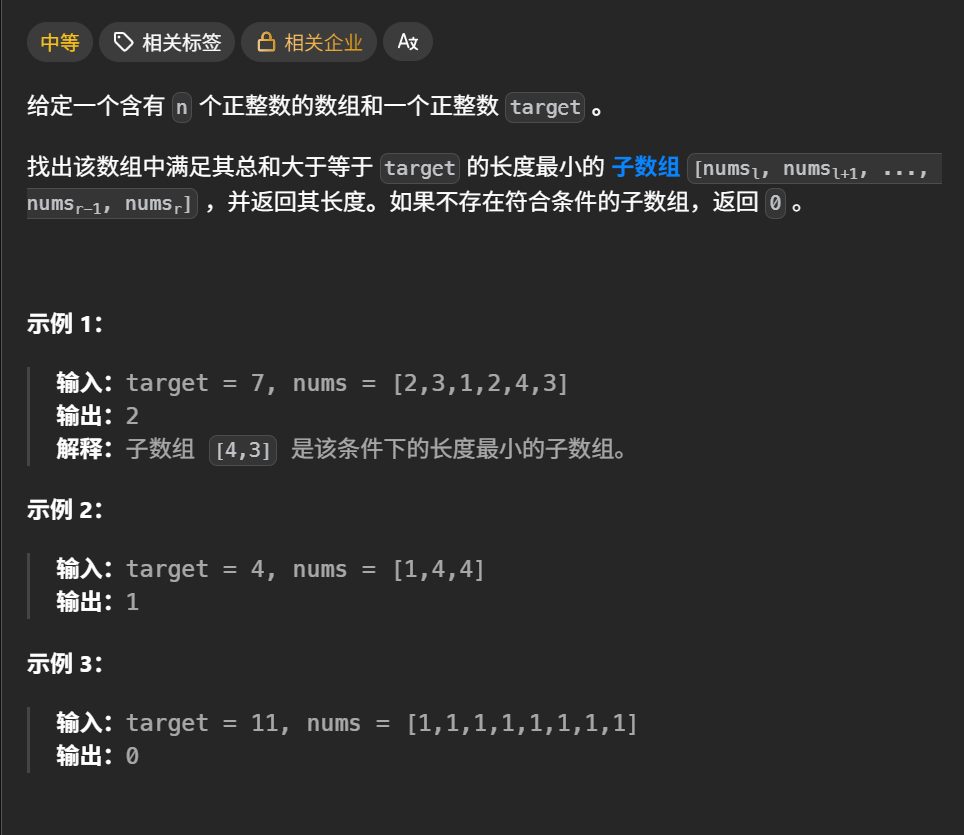
class Solution: def minSubArrayLen(self, target: int, nums: list[int]) -> int: n=len(nums) size=n+1 left=0 sum=0 for right,x in enumerate(nums): sum+=x while sum-nums[left]>=target: sum-=nums[left] left+=1
if sum>=target: size=min(size,right-left+1)
return 0 if size==n+1 else size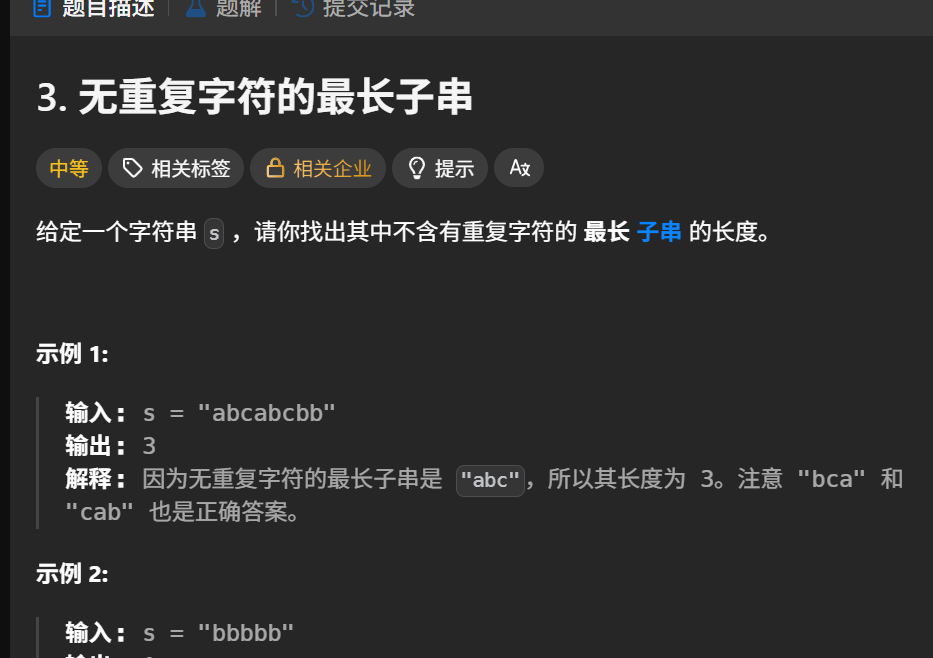
class Solution: def lengthOfLongestSubstring(self, s: str) -> int: ans=0 left=0 #创建一个空的 `Counter`,它可以当作一个“自动计数的字典”使用
cnt=Counter() #hashmap char int #cnt[char]=int cnt内部包裹
for right,x in enumerate(s): cnt[x]+=1 while cnt[x]>1: cnt[s[left]]-=1 left+=1 ans=max(ans,right-left+1) return ans哈希集合
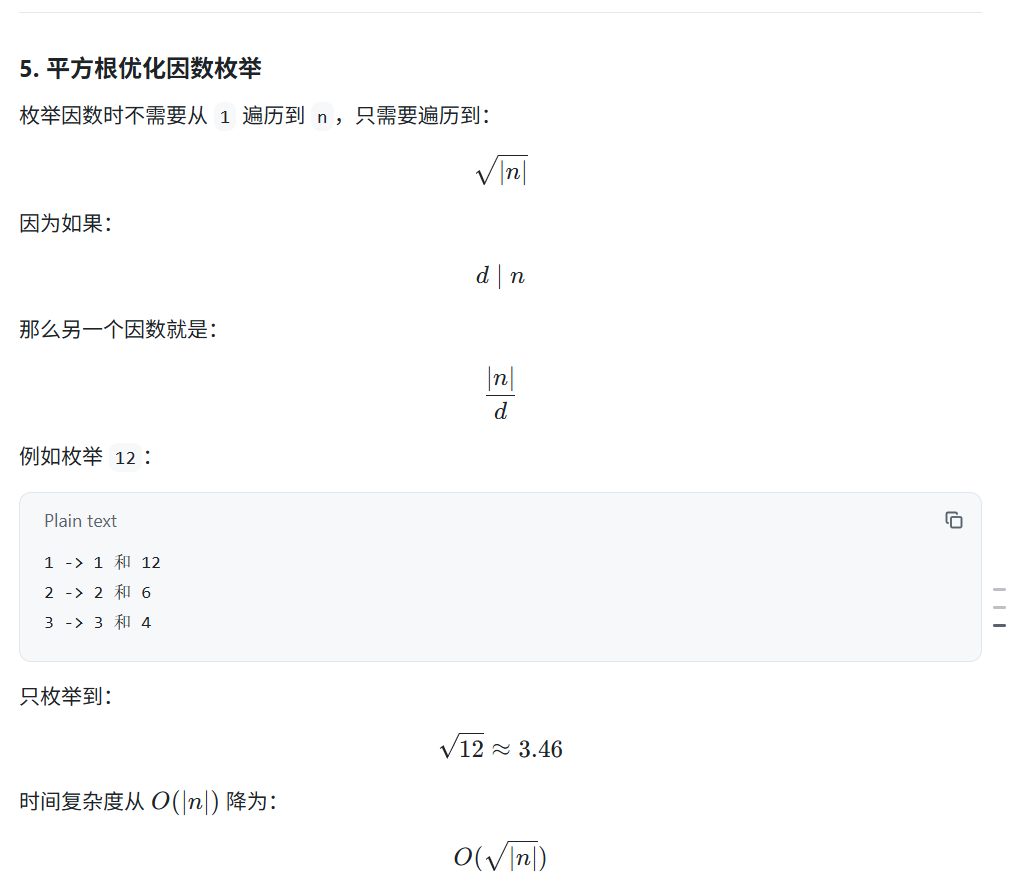
class Solution: def lengthOfLongestSubstring(self, s: str) -> int: ans=0 left=0 windows=set() for r,c in enumerate(s): while c in windows: windows.remove(s[left]) left+=1 windows.add(c) ans=max(ans,r-left+1) return ans如果 d 是 n 的正因数,那么:
d 和 -d 都可能是因数。
import sysfrom math import isqrtinput=lambda:sys.stdin.readline().strip()
def ysh(n): result=[] # 枚举因数,平方根优化 limit=isqrt(abs(n))
for d in range(1,limit+1): if(n%d==0): # e.g 3 -3 result.append(d) result.append(-d) # 枚举另一半的因数 e.g(12/3=4) other=abs(n)//d if(other!=d): result.append(other) result.append(-other)
return result
t=int(input())
for _ in range(t): a,b,c=map(int,input().split())
#a!=0 flag=0 # 有没有解 初始化无解
for a1 in ysh(a): a2=a//a1
# c!=0 b!=0 if(c!=0): for b2 in ysh(c): b1=c//b2 if(a1*b2+a2*b1==b): print(a1,b1,a2,b2) flag=1 break # c=0 b1=0/b2=0 else: # b1=0 a1*b2=b if(b%a1==0): b1=0 b2=b//a1 print(a1,b1,a2,b2) flag=1
# b2=0 a2*b1=b elif(b%a2==0): b2=0 b1=b//a2 print(a1,b1,a2,b2) flag=1 if(flag==1): break
if(flag==0): print("NO")判定条件:
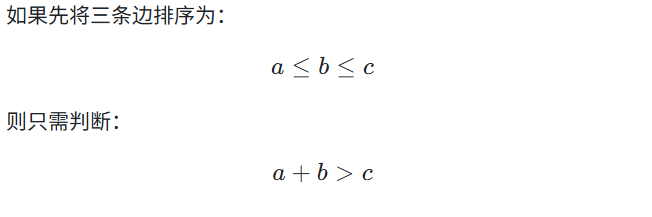
import sysfrom math import isqrtinput=lambda:sys.stdin.readline().strip()
def pdss(t): if(t<2): return False elif(t==2): return True elif(t%2==0): return False else: t1=isqrt(t) for i in range(3,t1+1,2): if(t%i==0): return False return True(找出质数)
段代码是在用埃拉托斯特尼筛法,一次性找出 2 ~ 10005 之间的所有质数。
m = 10005vis = [False] * (m + 1)pri = []m:筛选范围上限。vis[i]:表示数字 i 是否已经被确定为合数。
False:暂时没被标记,可能是质数。True:一定是合数。pri:保存找到的质数。核心代码:
for i in range(2, m + 1): if not vis[i]: pri.append(i)
for j in range(i * i, m + 1, i): vis[j] = True具体过程:
i 没被标记if not vis[i]:说明 i 是质数。
例如开始时:
i = 22 没有被标记,所以 2 是质数。
pri.append(2)把 2 加入质数数组。
i 的倍数for j in range(i * i, m + 1, i): vis[j] = True当 i = 2 时,会标记:
4, 6, 8, 10, 12, ...因为它们都是 2 的倍数,一定不是质数。
当 i = 3 时,会标记:
9, 12, 15, 18, ...当 i = 5 时,会标记:
25, 30, 35, ...最终,所有没有被标记的数就是质数。
为什么从 i * i 开始?
以 i = 5 为例:
5 * 2 = 105 * 3 = 155 * 4 = 20这些数已经分别被 2、3、4 标记过了,所以不需要重复标记。第一个可能还没被标记的倍数就是:
5 * 5 = 25因此从 i * i 开始可以提高效率。
例如最终:
pri[:10]大致是:
[2, 3, 5, 7, 11, 13, 17, 19, 23, 29]你看到的:
[i \* i]其中的反斜杠只是网页显示时的转义,实际 Python 代码应写成:
[i * i]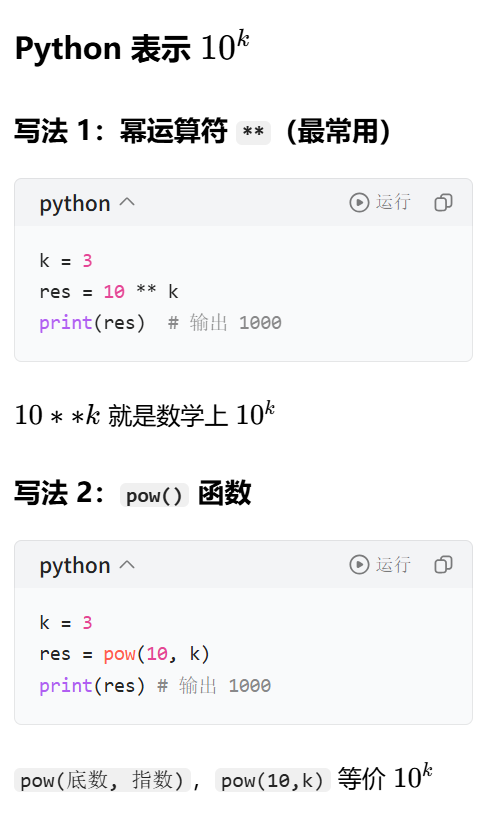
取模
(a % m + b % m) % m = (a + b) % m(a % m × b % m) % m = (a × b) % m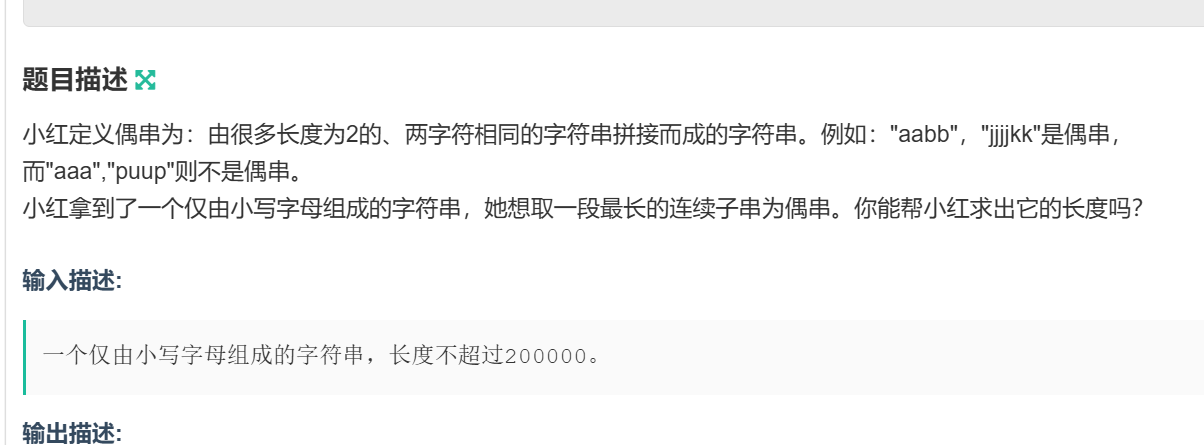
1.定义状态
dp[i]=以s[i]结尾的最长合法的偶子串长度2.找状态转移
如果最后两个相同
s[i]==s[i-1]可以组成一对偶子串
dp[i]=当前长度+2即
dp[i]=dp[i-2]+2如果不相同
dp[i]=0求最终答案
ans=max(dp[i])import sysinput=lambda:sys.stdin.readline().strip()
s=input()n=len(s)ans=0dp=[0]*nfor i in range(1,n): if(s[i]==s[i-1]): if(i>=2): dp[i]=dp[i-2]+2 else: dp[i]=2 ans=max(ans,dp[i])
print(ans)D - Installation of Street Lights
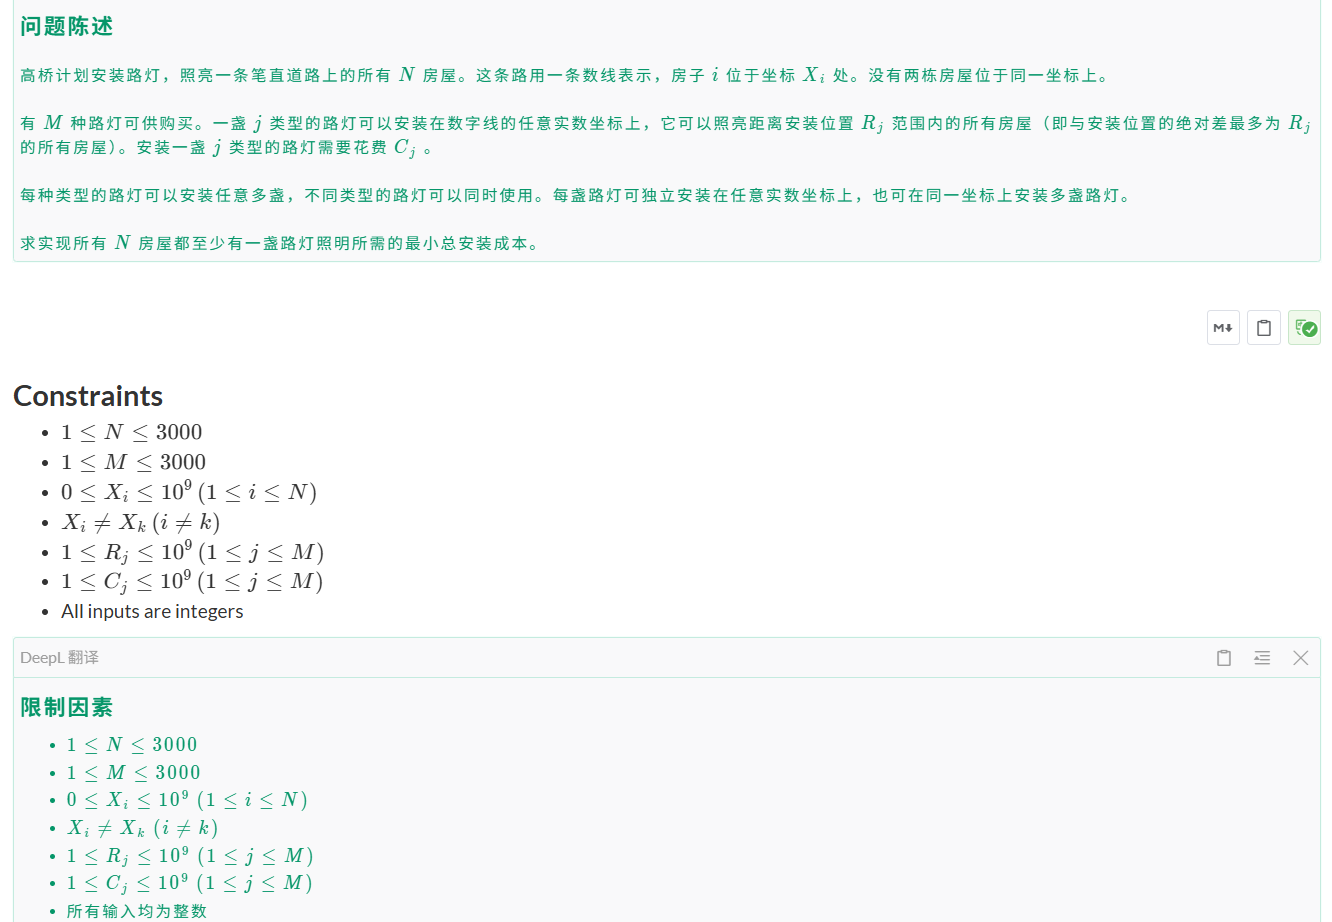
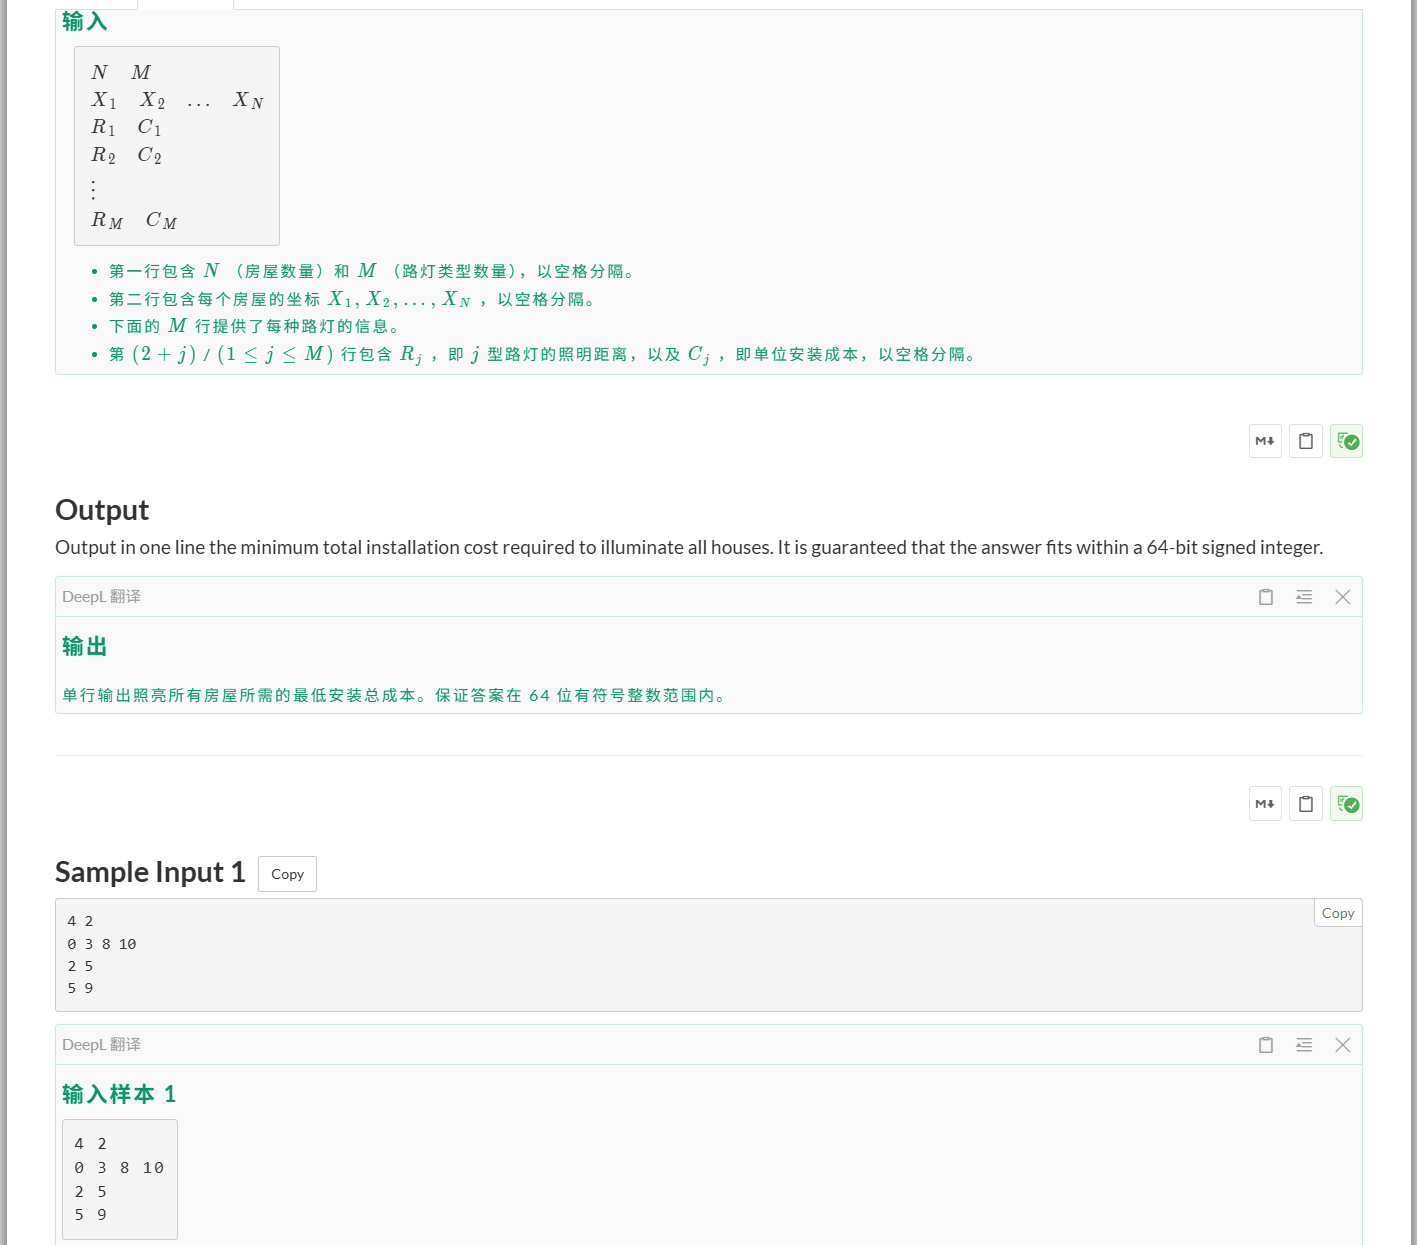
核心公式:
dp[right + 1] = min(dp[right + 1], dp[left] + cost)意思是:
用当前这盏灯覆盖一段房子后,更新 dp[right + 1],取原来的方案和新方案中花费较小的那个。
假设当前灯覆盖下标:
Plain text
left 到 right例如:
Plain text
left = 2right = 4说明当前灯覆盖第 2、3、4 栋房子。
Python
dp[right + 1]也就是:
Python
dp[5]表示:
照亮前 5 栋房子的最小花费。
因为下标 0, 1, 2, 3, 4 一共是 5 栋。
当前灯覆盖:
Plain text
left 到 right那么在使用当前灯之前,前面的 left 栋房子已经被照亮:
Python
dp[left]当前灯花费:
Python
cost所以新方案总花费是:
Python
dp[left] + costPython
dp[right + 1] = min( dp[right + 1], dp[left] + cost)可以读成:
Plain text
dp[right + 1] 等于以下两个数中较小的一个:
1. dp[right + 1]:原来的最优方案2. dp[left] + cost:先照亮前 left 栋,再安装当前灯假设:
Python
left = 2right = 4dp[2] = 5cost = 9dp[5] = 20当前灯覆盖第 2 到第 4 栋房子。
新方案花费:
Python
dp[2] + 9 = 5 + 9 = 14原来照亮前 5 栋房子需要:
Python
dp[5] = 20所以更新为:
Python
dp[5] = min(20, 14)结果:
Python
dp[5] = 14也就是找到了一种更便宜的方案。
你只需要记住这一句:
Python
dp[右端点 + 1] = min(原来的花费, 前面的花费 + 当前灯的花费)right + 1 不是“多覆盖一栋房子”,而是因为下标从 0 开始,前 right + 1 栋房子的最后下标正好是 right。
假设有 5 栋房子,下标是:
Plain text
房子下标: 0 1 2 3 4房子数量: 1 2 3 4 5所以:
0,一共覆盖 1 栋;0~1,一共覆盖 2 栋;0~2,一共覆盖 3 栋;0~4,一共覆盖 5 栋。规律就是:
Plain text
覆盖到下标 right=> 一共覆盖 right + 1 栋房子因此要记录到:
Python
dp[right + 1]dp[i] 的含义我们规定:
Python
dp[i] = 照亮前 i 栋房子的最小花费这里的“前 i 栋”是:
Plain text
下标 0 到 i-1例如:
Python
dp[3]表示照亮:
Plain text
下标 0、1、2一共 3 栋房子。
不是表示下标为 3 的那一栋房子。
假设当前灯覆盖:
Plain text
left = 2right = 4也就是覆盖:
Plain text
下标 2、3、4前面已经覆盖的是:
Plain text
下标 0、1一共 2 栋,所以之前的状态是:
Python
dp[left] = dp[2]使用当前灯后,覆盖范围变成:
Plain text
下标 0、1、2、3、4一共 5 栋房子,所以应该更新:
Python
dp[5]而:
Python
right + 1 = 4 + 1 = 5所以代码是:
Python
dp[right + 1] = min(dp[right + 1], dp[left] + cost)Plain text
下标: 0 1 2 3 4 |----|----|----|----|前两栋: 已覆盖 已覆盖
当前灯覆盖: [---- 2、3、4 ----]
最终覆盖: [0、1、2、3、4] 一共 5 栋所以最终状态是:
Python
dp[5]而不是 dp[4]。
dp[right]?如果写成:
Python
dp[right]例如 right = 4,那表示:
Python
dp[4]也就是只表示前 4 栋房子:
Plain text
下标 0、1、2、3它漏掉了下标为 4 的那栋房子。
所以必须写:
Python
dp[right + 1]如果当前灯覆盖:
Plain text
left 到 right那么:
Python
dp[left]表示覆盖当前灯之前的房子;
Python
dp[right + 1]表示覆盖当前灯之后的房子。
完整转移:
Python
dp[right + 1] = min( dp[right + 1], dp[left] + cost)读作:
覆盖到下标 right,实际上已经覆盖了前 right + 1 栋房子。新的花费等于“前面的花费 + 当前灯的花费”。
和原来的方案比较,取较小值。
现在换一种枚举方式。
我们枚举当前灯覆盖的最右边房子 right。
假设:
houses[right]radius如果它最早覆盖到 left,必须满足:
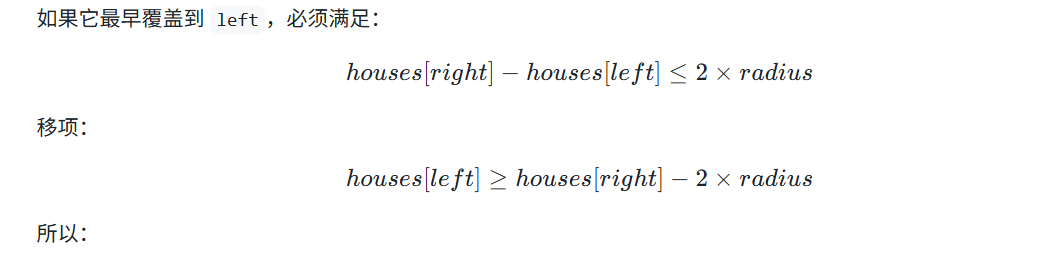
Python
min_position = houses[right] - 2 * radius我们要找:
第一个坐标大于等于 min_position 的房子。
因为房子坐标已经排序,所以可以用二分查找:
左闭右开
bisect_left(数组, 目标值, 起始位置, 结束位置)Python
left = bisect_left(houses,min_position,0,right + 1)这里限制到 right + 1,是因为不能让 left 跑到 right 后面。
import sysfrom bisect import bisect_left
input = sys.stdin.readline# n房屋数量,m路灯种类n, m = map(int, input().split())
# 房屋坐标x = list(map(int, input().split()))x.sort()
# lp[i] = (照明半径, 安装费用)lp = []
for _ in range(m): r, c = map(int, input().split()) lp.append((r, c))
INF = 10 ** 30
# dp[i]:照亮前 i 栋房子的最小费用dp = [INF] * (n + 1)dp[0] = 0
# 枚举当前灯覆盖的最右边房子for i in range(n): # 枚举每种路灯 # r照亮半径,c范围 for r, c in lp: # 当前路灯最左能够覆盖到的坐标 p = x[i] - 2 * r
# 找到第一个坐标 >= p 的房子下标 # bisect_left(数组, 目标值, 起始位置, 结束位置) l = bisect_left(x, p, 0, i + 1)
# 当前路灯覆盖第 l 到第 i 栋房子 # 前 l 栋房子已经被照亮 dp[i + 1] = min(dp[i + 1], dp[l] + c)
print(dp[n])他妈的,我头要炸了,这dp 我晕了
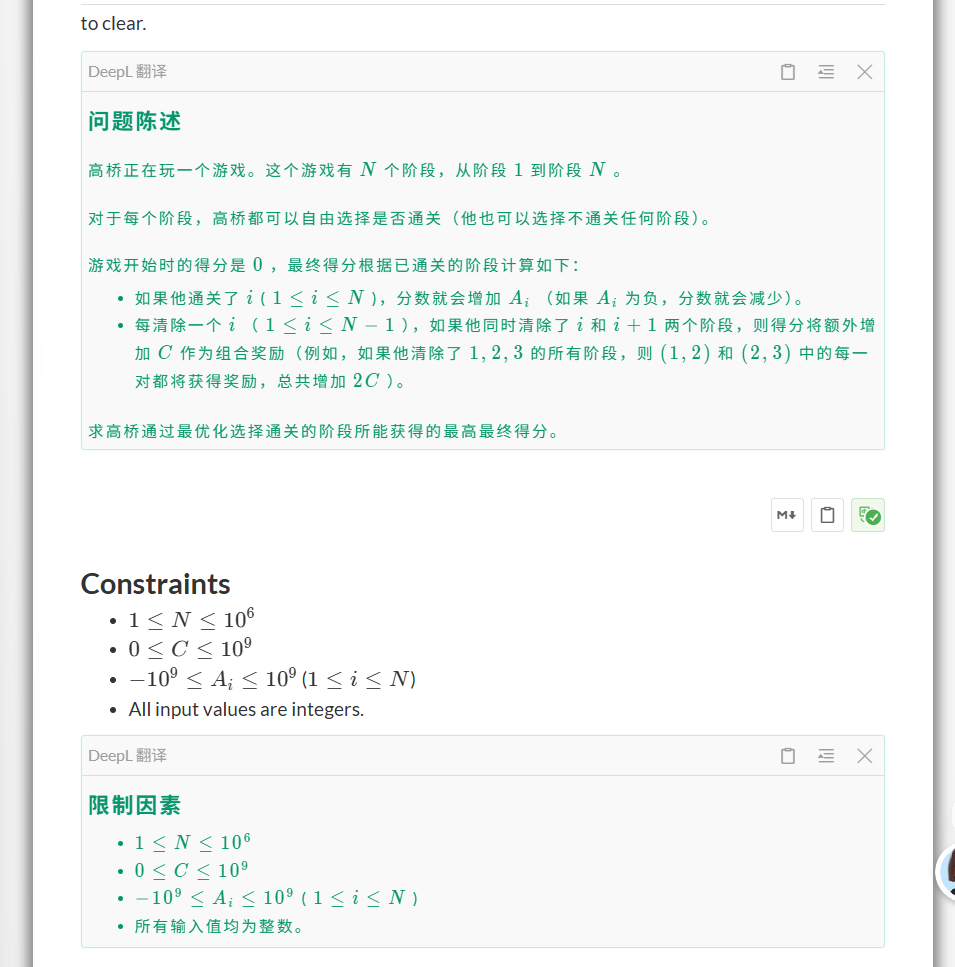
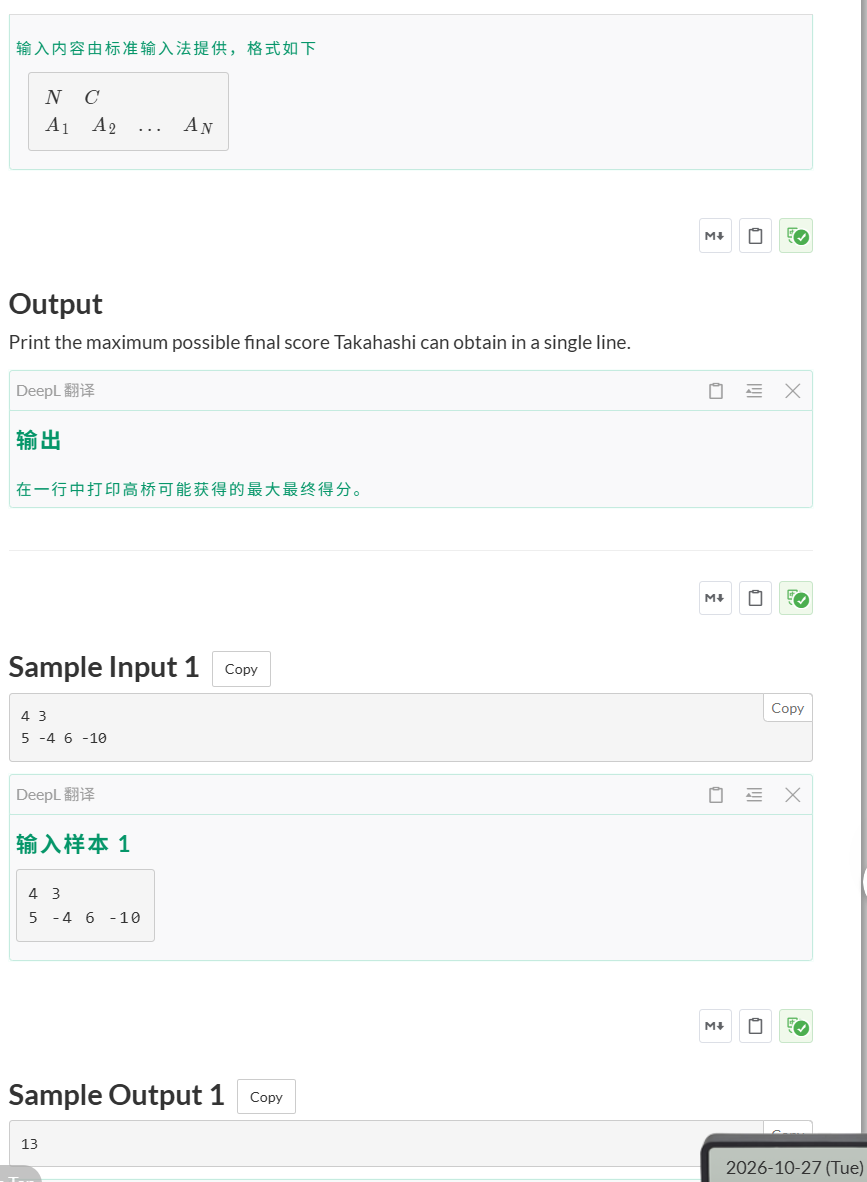
https://gist.github.com/xue120754/d78ce0fa023c8590a540da77ae216aa9
import sysinput = sys.stdin.buffer.readline# N:阶段数量# C:两个相邻阶段都通过时获得的额外奖励N, C = map(int, input().split())
# 每个阶段单独通过时获得的分数scores = list(map(int, input().split()))
# dp0:# 处理完前面的阶段后,最后一个阶段不通过时的最大分数dp0 = 0
# dp1:# 处理完前面的阶段后,最后一个阶段通过时的最大分数# 一开始没有阶段,不可能处于“最后一个阶段通过”的状态dp1 = -10**30
for score in scores: # 当前阶段不通过: # 上一个阶段无论通过还是不通过,都不会产生新的分数 new_dp0 = max(dp0, dp1)
# 当前阶段通过: # 1. 上一个阶段不通过:增加 score # 2. 上一个阶段通过:增加 score + C new_dp1 = max( dp0 + score, dp1 + score + C )
# 进入下一阶段 dp0 = new_dp0 dp1 = new_dp1
# 最后一个阶段可以通过,也可以不通过print(max(dp0, dp1))不重复加减,只维护变化的部分
差分数组不记录“当前位置有多少”,而记录“从这里开始增加或减少多少”。
位置: 1 2 3 4 5数值: 0 0 0 0 0现在给区间 [2, 4] 每个位置加 1,结果应该是:
位置: 1 2 3 4 5数值: 0 1 1 1 0如果暴力修改,需要:
a[2] += 1a[3] += 1a[4] += 1差分的想法是:
从位置 2 开始,后面都增加 1从位置 5 开始,取消这次增加所以只记录:
d[2] += 1d[5] -= 1此时差分数组是:
位置: 1 2 3 4 5差分: 0 1 0 0 -1注意:差分数组本身还不是最终答案。
再前缀和后就得到答案:
从左到右累加差分
位置 1:0位置 2:0 + 1 = 1位置 3:1 + 0 = 1位置 4:1 + 0 = 1位置 5:1 + (-1) = 0这正好是我们想要的结果。
因此:
d[l] += 1d[r + 1] -= 1含义是:
d[l] += 1:从 l 开始,覆盖次数增加;d[r + 1] -= 1:从 r + 1 开始,覆盖次数取消。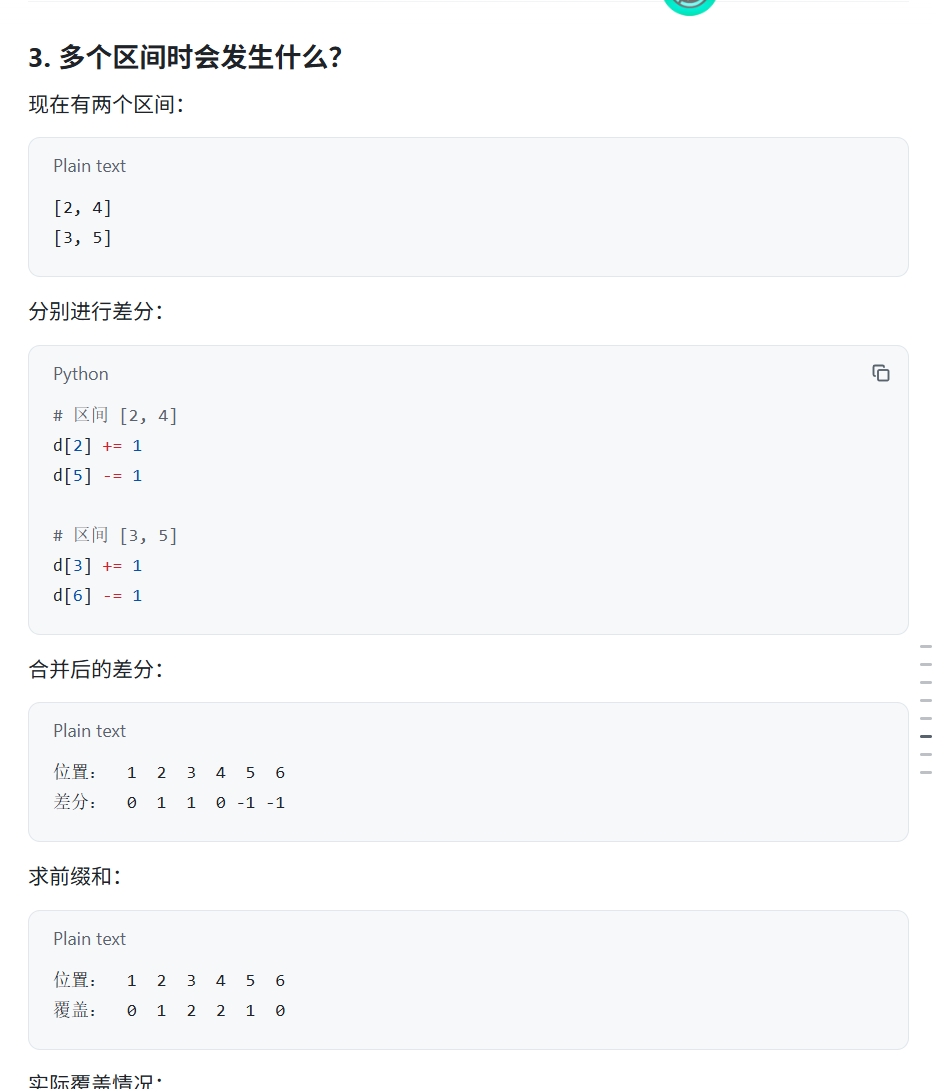
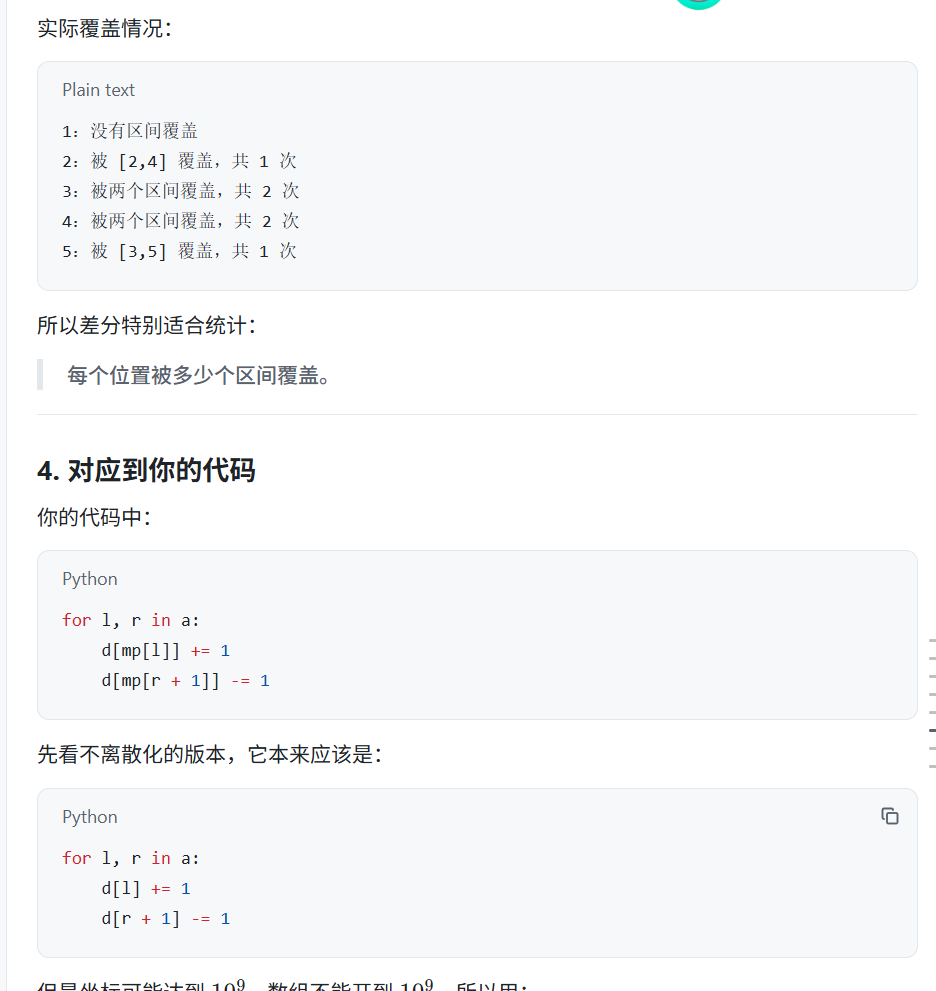
前缀和
s = [0] * len(x)now = 0
for i in range(len(x)): #表示把当前位置的“变化量”累加到当前覆盖次数 now += d[i] #表示保存当前位置最终的覆盖次数 s[i] = now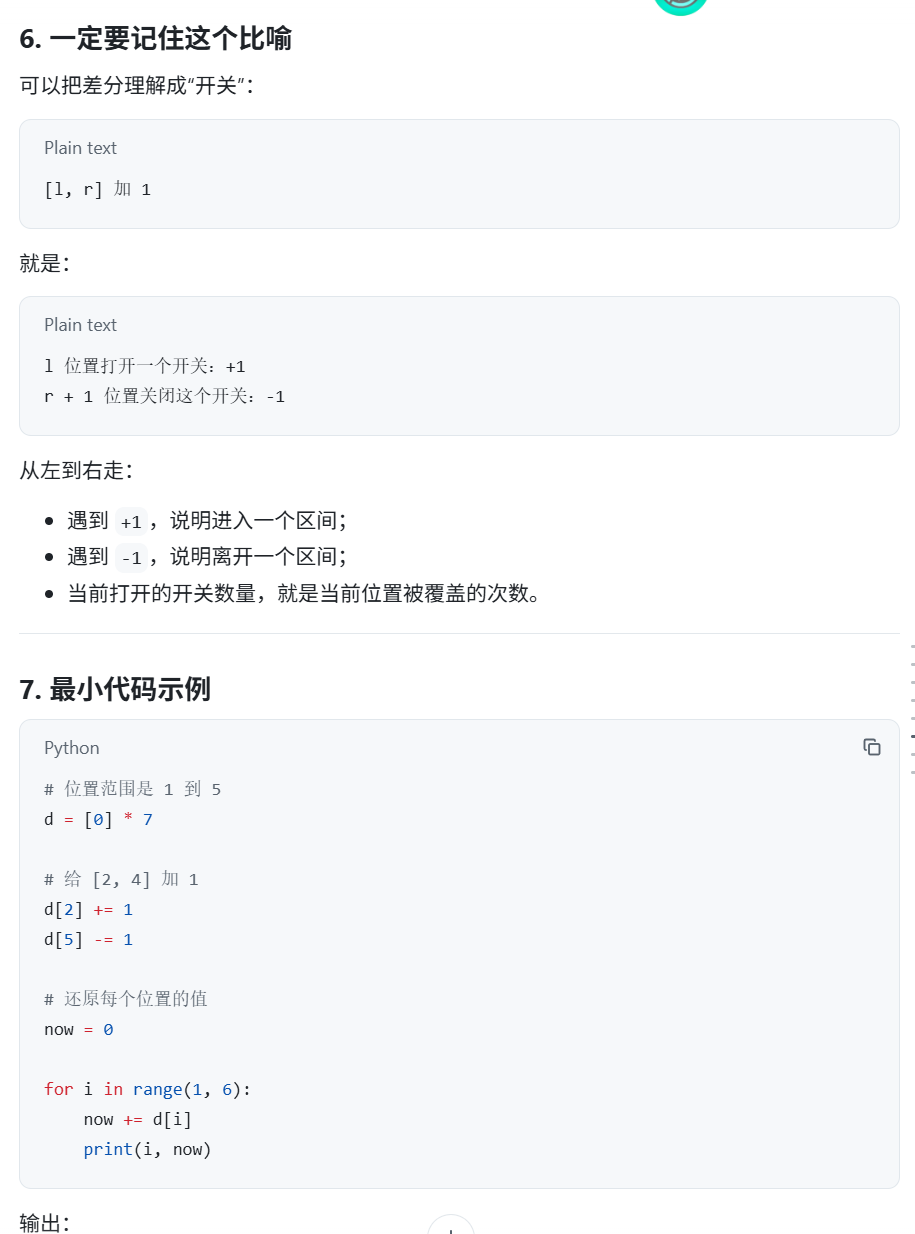
https://gist.github.com/xue120754/dee866808065682018b29fa3b045a4e3
差分数组不记录“当前位置有多少”,而记录“从这里开始增加或减少多少”。
区间、集合、字典、离散化、差分数组、前缀和
这段代码里的离散化,目的是:
原坐标可能很大,不能直接用坐标当数组下标;于是把真正出现的坐标压缩成连续的小下标。
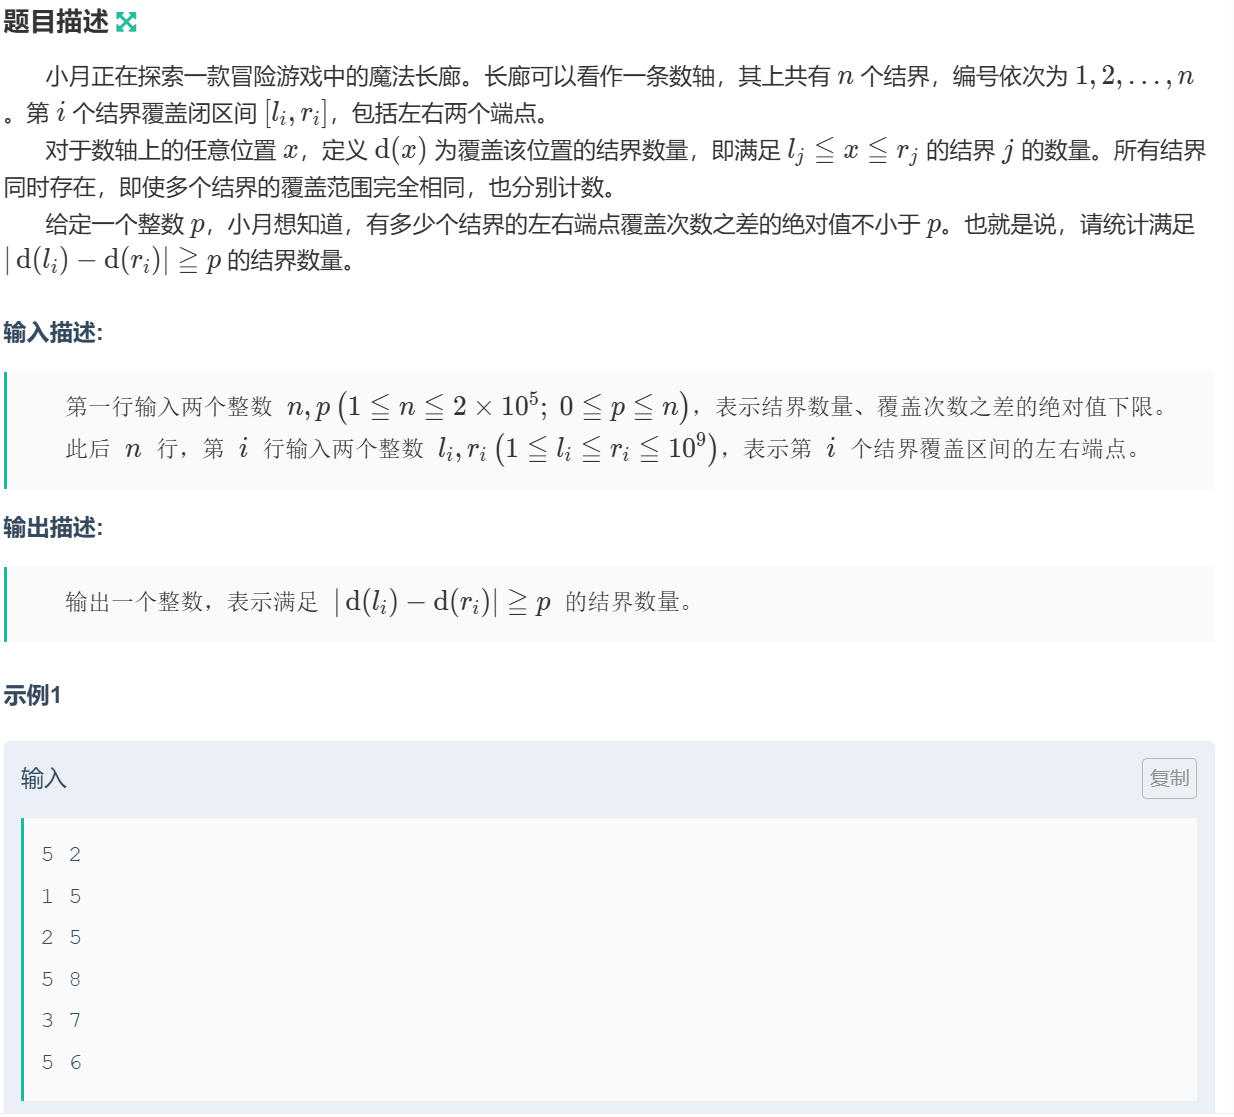
import sys
input = sys.stdin.readline
n, p = map(int, input().split())
# 保存所有区间a = []
# 保存所有需要离散化的坐标x = set()
for _ in range(n): l, r = map(int, input().split())
a.append((l, r))
x.add(l) x.add(r) x.add(r + 1)
# 排序、去重x = sorted(x)
# 建立:原坐标 -> 离散下标mp = {}
for i in range(len(x)): mp[x[i]] = i
# 差分数组d = [0] * (len(x) + 1)
# 处理每个区间 [l, r]for l, r in a: d[mp[l]] += 1 d[mp[r + 1]] -= 1
# 求前缀和,得到每个坐标的覆盖次数s = [0] * len(x)now = 0
for i in range(len(x)): now += d[i] s[i] = now
# 统计答案ans = 0
for l, r in a: v1 = s[mp[l]] v2 = s[mp[r]]
if abs(v1 - v2) >= p: ans += 1
print(ans)import sys
input = sys.stdin.readline
# 读取区间数量 n,以及判断条件 pn, p = map(int, input().split())
# 保存所有区间lr = []
# 差分字典d = {}
for _ in range(n): l, r = map(int, input().split()) lr.append((l, r))
# 保证这些坐标之后可以被查询 #如果键不存在,就添加这个键并设置默认值;如果键已经存在,就保持原值不变。 d.setdefault(l, 0) d.setdefault(r, 0) d.setdefault(r + 1, 0)# e.g d.setdefault(5, 0)# {5: 0}# d[5] = 0 # 区间 [l, r] 覆盖次数加 1 d[l] += 1
# 从 r + 1 开始取消覆盖 d[r + 1] -= 1
# 按坐标从小到大进行前缀累加now = 0#dx是d前缀和后的结果dx = {}
for x in sorted(d): now += d[x] dx[x] = now
# 统计答案ans = 0
for l, r in lr: # 查询 l 和 r 位置的覆盖次数 if abs(dx[l] - dx[r]) >= p: ans += 1
print(ans)复盘版
import sysinput=lambda:sys.stdin.readline().strip()
n,p=map(int,input().split())
lr=[]
d={}for _ in range(n):
l,r=map(int,input().split()) lr.append((l,r))
d.setdefault(l,0) d.setdefault(r,0) d.setdefault(r+1,0)
d[l]+=1 d[r+1]-=1
now=0#对dx进行d的前缀和操作dx={}##对字典直接使用 `sorted`,排序的是**字典的键**.# 把字典中所有坐标从小到大取出来,# 每次取一个坐标放到变量 `x` 中。for x in sorted(d): now+=d[x] #不可以写dx[x]+=now y因为最开始dx是空字典 dx[x]=nowcnt=0#应该从 `lr` 中取出每一个区间:#for i in range(n):for l,r in lr: if(abs(dx[r]-dx[l])>=p): cnt+=1print(cnt)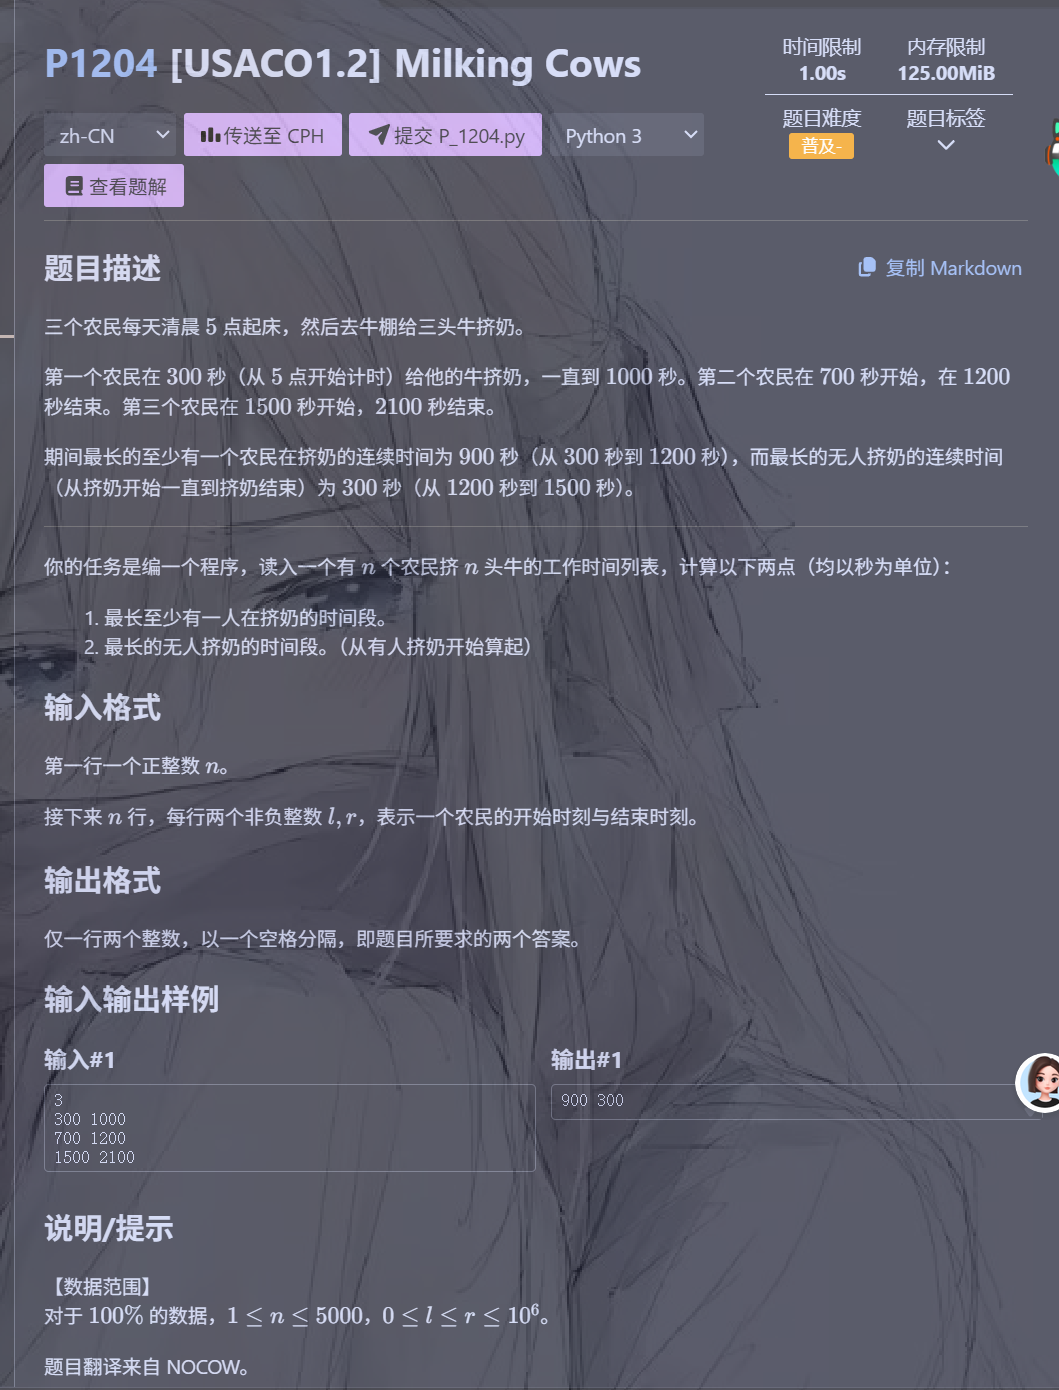
import sysinput=lambda:sys.stdin.readline().strip()
n=int(input())l1=[]r1=[]
for _ in range(n): l2,r2=map(int,input().split()) l1.append(l2) r1.append(r2)
k=max(r1)d=[0]*(k+1)for i in range(n): d[l1[i]]+=1 d[r1[i]]-=1
st=[0]*know=0for i in range(k): now+=d[i] st[i]=now
ans1=0ans2=0cnt1=0cnt2=0
l=min(l1)
for i in range(min(l1),max(r1)): if(st[i]>=1): cnt2=0 cnt1+=1 ans1=max(cnt1,ans1) else: cnt1=0 cnt2+=1 ans2=max(cnt2,ans2)print(ans1,ans2)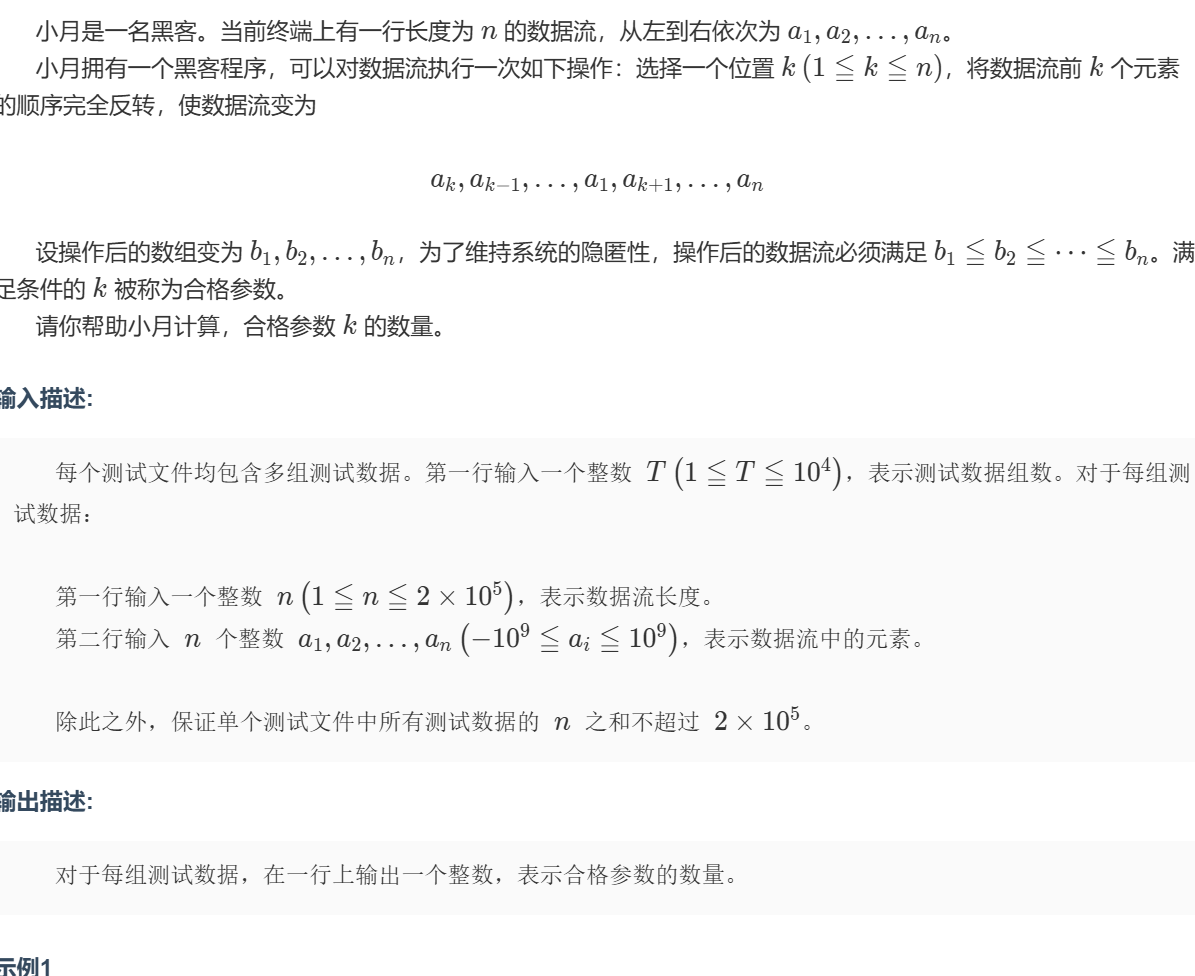
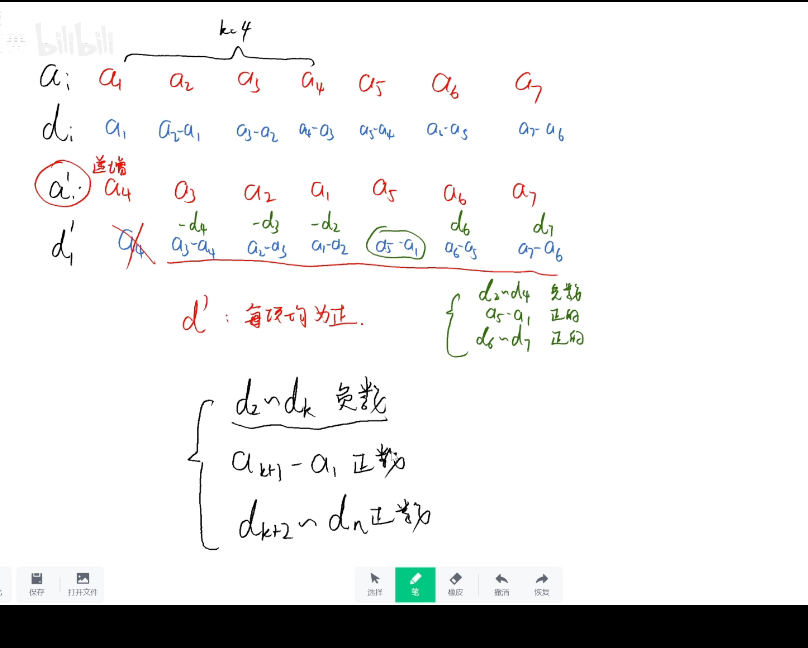
import sys
input = sys.stdin.readline
t = int(input())
for _ in range(t): n = int(input()) a = [0] + list(map(int, input().split()))
d = [0] * (n + 1)
for i in range(2, n + 1): d[i] = a[i] - a[i - 1]
# suf[i] 表示 d[i] 到 d[n] 是否全部 >= 0 suf = [True] * (n + 2)
for i in range(n, 1, -1): suf[i] = suf[i + 1] and d[i] >= 0
ans = 0 left_ok = True #不要每次重新计算全部内容, #而是记录之前的结果,只更新刚刚变化的部分 for k in range(1, n + 1): # 维护 d[2] 到 d[k] 是否全部 <= 0 # 如果k=1没有前缀就只需要判断后缀 if k >= 2: left_ok = left_ok and d[k] <= 0
# 前缀反转后是非递减的 if not left_ok: continue
# 后缀 a[k+1], ..., a[n] 非递减 if k < n and not suf[k + 2]: continue
# 反转后的前缀与后缀可以连接 if k < n and a[1] > a[k + 1]: continue
ans += 1
print(ans)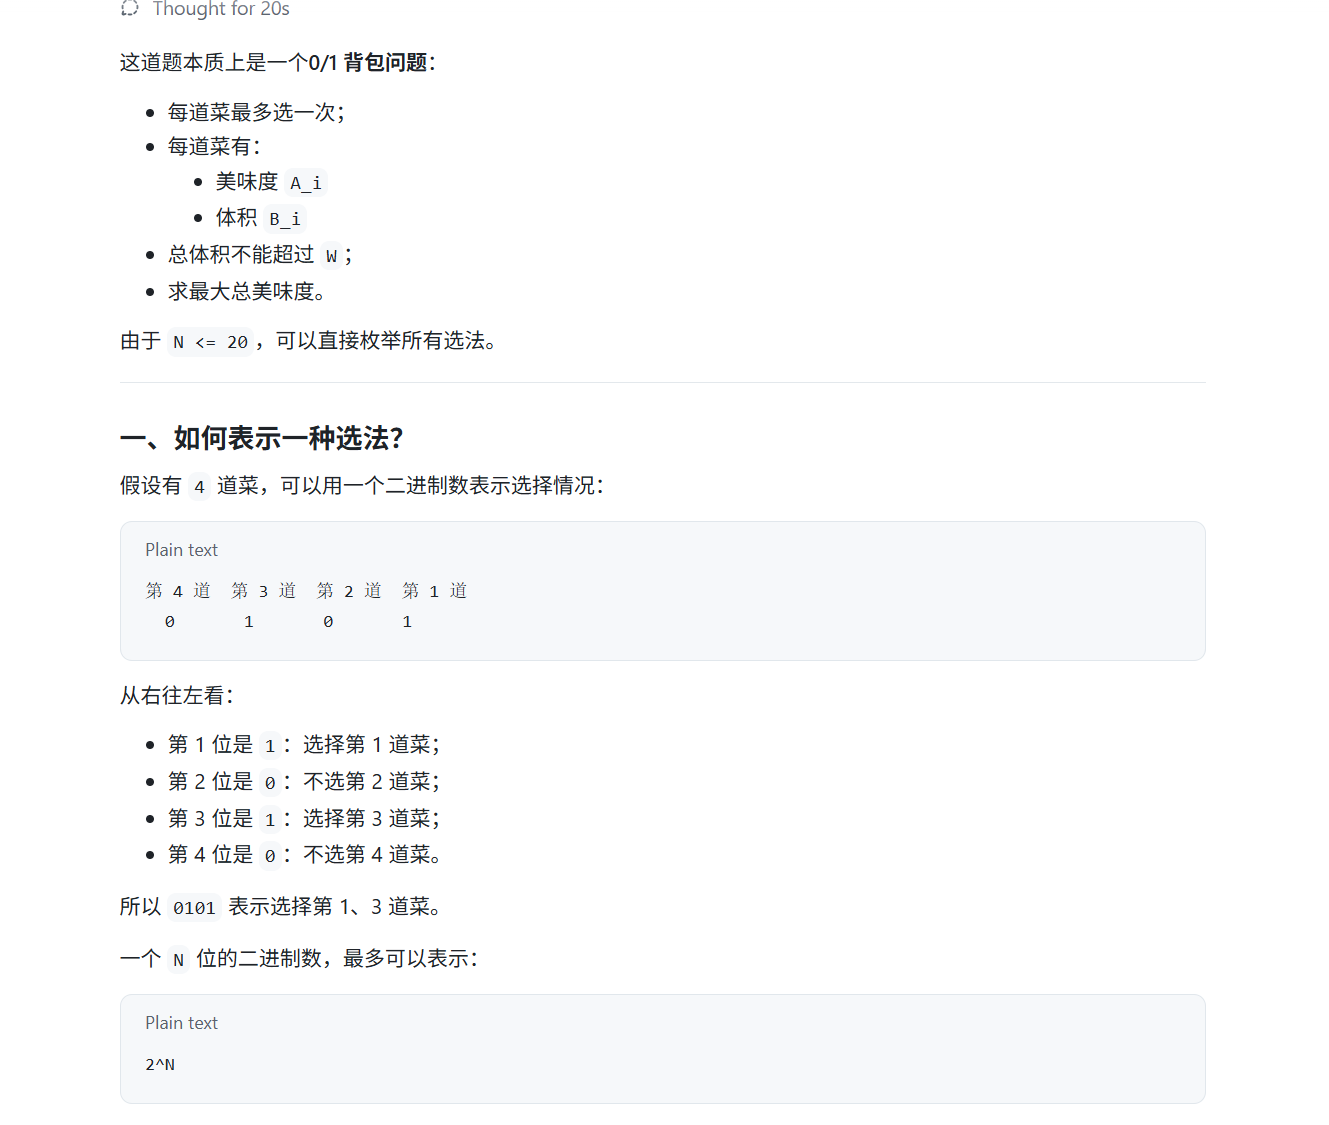
import sys
# 使用 readline 读取输入,速度更快input = sys.stdin.readline
# 读取菜品数量 n 和午餐盒最大容量 wn, w = map(int, input().split())
# delicious[i] 表示第 i 道菜的美味度delicious = []
# volume[i] 表示第 i 道菜的体积volume = []
# 读取 n 道菜的信息for _ in range(n): a, b = map(int, input().split())
# a 是美味度 delicious.append(a)
# b 是体积 volume.append(b)
# answer 表示目前找到的最大美味度answer = 0
# 一共有 2^n 种选择方案## mask 可以理解为一个二进制数:# mask 的第 i 位为 1,表示选择第 i 道菜;# mask 的第 i 位为 0,表示不选择第 i 道菜。## 例如 n = 3 时:## mask = 0 -> 000 -> 一道菜都不选# mask = 1 -> 001 -> 选择第 0 道菜# mask = 2 -> 010 -> 选择第 1 道菜# mask = 3 -> 011 -> 选择第 0、1 道菜# mask = 4 -> 100 -> 选择第 2 道菜#for mask in range(1 << n):
# 当前选择方案的总美味度 total_delicious = 0
# 当前选择方案的总体积 total_volume = 0
# 检查每一道菜是否被选择 for i in range(n):
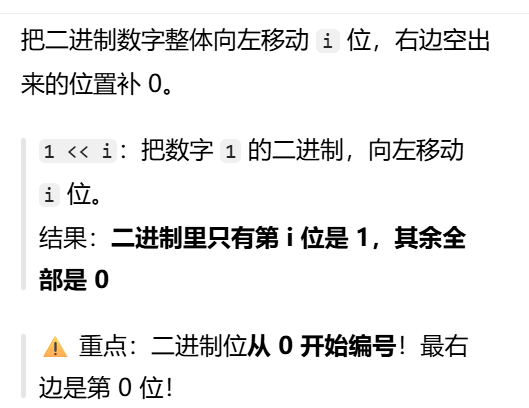
# 1 << i 表示只有第 i 位是 1 的二进制数 # # 例如: # i = 0 时,1 << i = 001 # i = 1 时,1 << i = 010 # i = 2 时,1 << i = 100 # # mask & (1 << i) 不等于 0, # 说明 mask 的第 i 位是 1, # 也就是选择了第 i 道菜。 #如果 `mask` 的第 `i` 位是 `1`,说明第 `i` 道菜被选择了。 if mask & (1 << i):
# 加上第 i 道菜的美味度 total_delicious += delicious[i]
# 加上第 i 道菜的体积 total_volume += volume[i]
# 如果总体积没有超过午餐盒容量 if total_volume <= w:
# 更新最大美味度 answer = max(answer, total_delicious)
# 输出所有合法选择方案中的最大美味度print(answer)1<<i:
&
&是按位与运算:两个比特都为 1,结果才是 1;否则为 0。
https://gist.github.com/xue120754/15855f0bc75928820651af2395b68eec
global answer 的意思是:
告诉 Python:函数里的 answer 使用函数外面定义的那个变量。
import sysinput = lambda:sys.stdin.readline().strip()
n,w=map(int,input().split())
a=[]b=[]
for _ in range(n): a1,b1=map(int,input().split()) a.append(a1) b.append(b1)
ans=0
def dfs(i,total_a,total_b): global ans
if(total_b>w): return if(i==n): ans=max(ans,total_a) return
dfs(i+1,total_a,total_b)
dfs(i+1,total_a+a[i],total_b+b[i])
dfs(0,0,0)
print(ans)sum[i]=sum[i-1]+a[i];
a[l]~a[r]=sum[r]-sum[l-1]
前缀和+哈希:
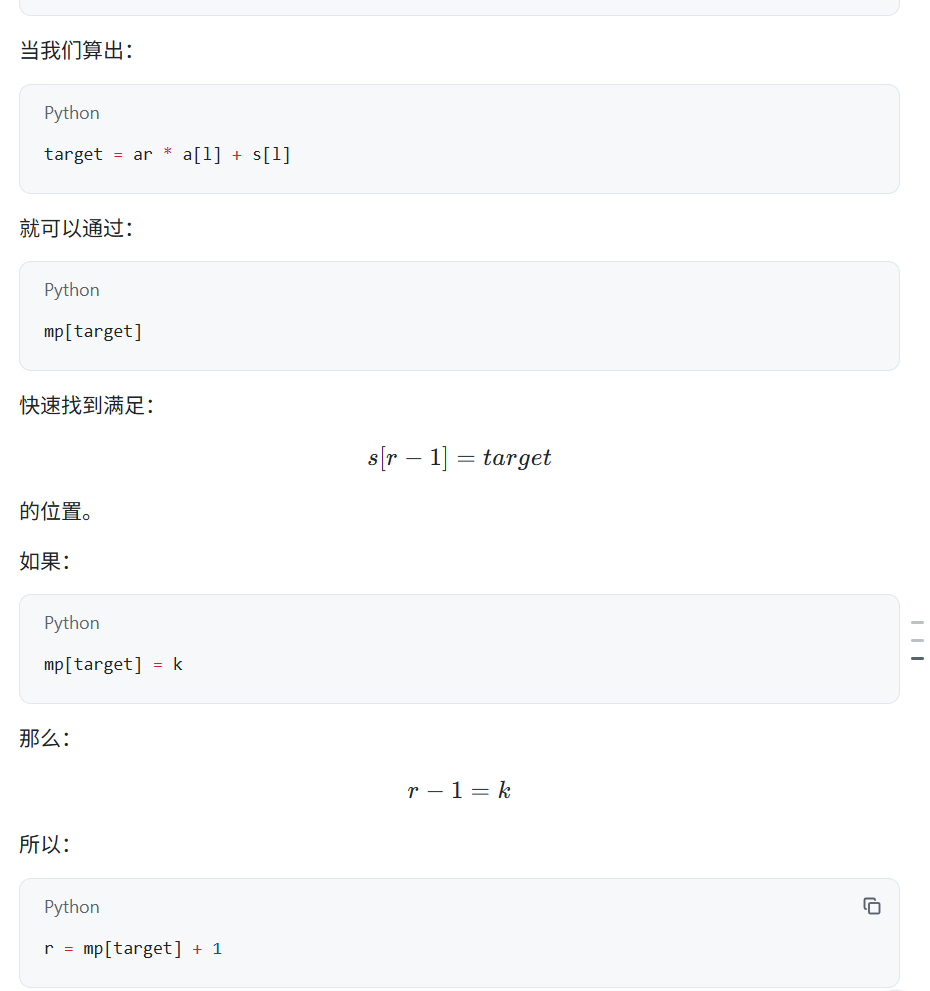
mp = {}
for i in range(1, n + 1): s[i] = s[i - 1] + a[i] #这个和s[i]对应的位置i mp[s[i]] = imp[某个前缀和] = 这个前缀和对应的下标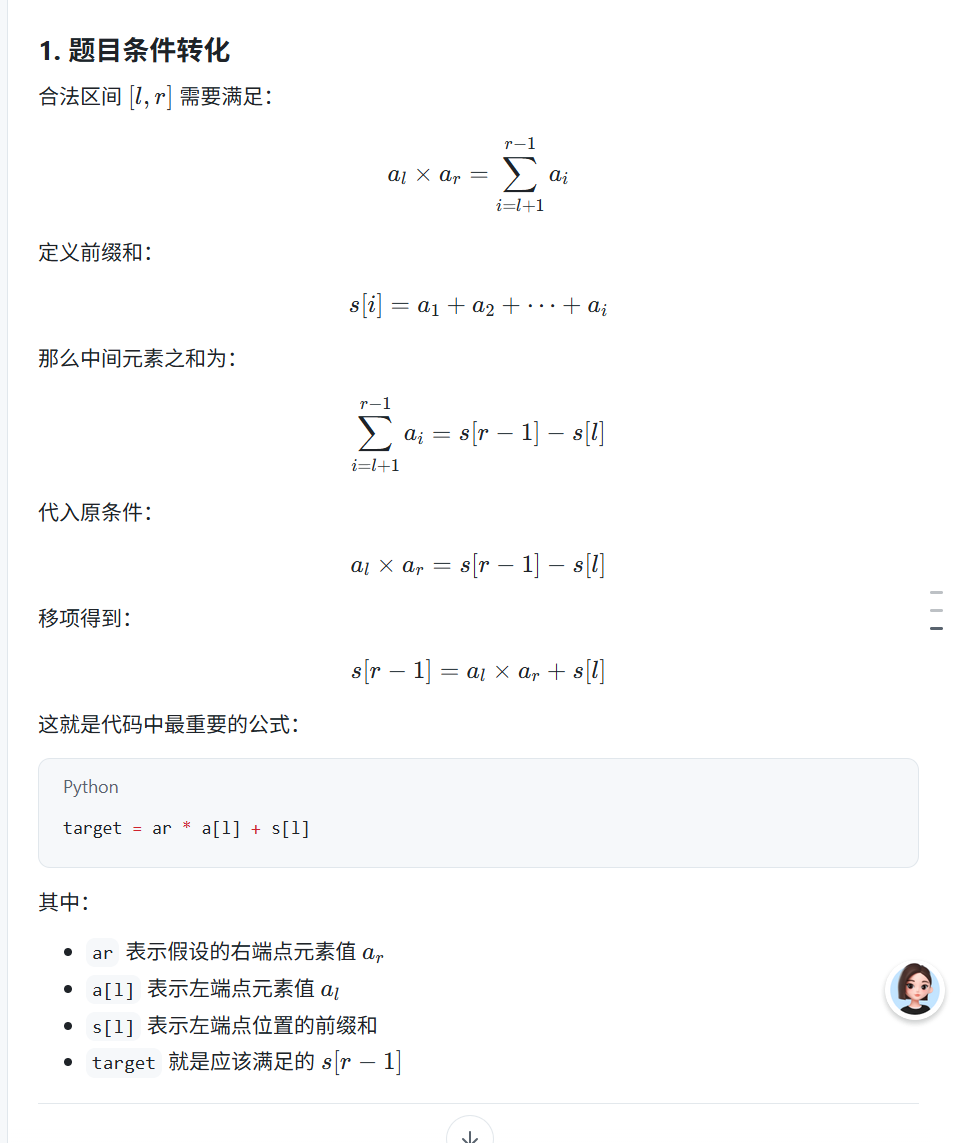
import sys
def solve(): input = sys.stdin.buffer.readline
n = int(input()) a = [0] + list(map(int, input().split()))
# s[i] 表示前 i 个元素的前缀和 s = [0] * (n + 1)
# mp[前缀和] = 对应的下标 mp = {}
# 计算前缀和,并记录前缀和对应的位置 for i in range(1, n + 1): s[i] = s[i - 1] + a[i] mp[s[i]] = i #记录个数 ans = 0
# 枚举左端点 l for l in range(1, n + 1):
# 枚举右端点元素 a[r] 的可能值 # 由于 1 <= a[i] <= 30,所以只需要枚举 1~30 for ar in range(1, 31):
# 由: # a[l] * a[r] = s[r - 1] - s[l] # # 得到: # s[r - 1] = a[l] * a[r] + s[l] target = ar * a[l] + s[l]
# 如果不存在这样的前缀和,跳过 if target not in mp: continue
# mp[target] 对应的是 r - 1 r = mp[target] + 1
# 右端点不能越界 if r > n: continue
# 确保右端点元素值就是当前枚举的 ar if a[r] != ar: continue
# 区间长度必须至少为 3 if r - l + 1 < 3: continue
# 找到一个合法区间 ans += 1
print(ans)
if __name__ == "__main__": solve()两个对应位置都是 1,结果才是 1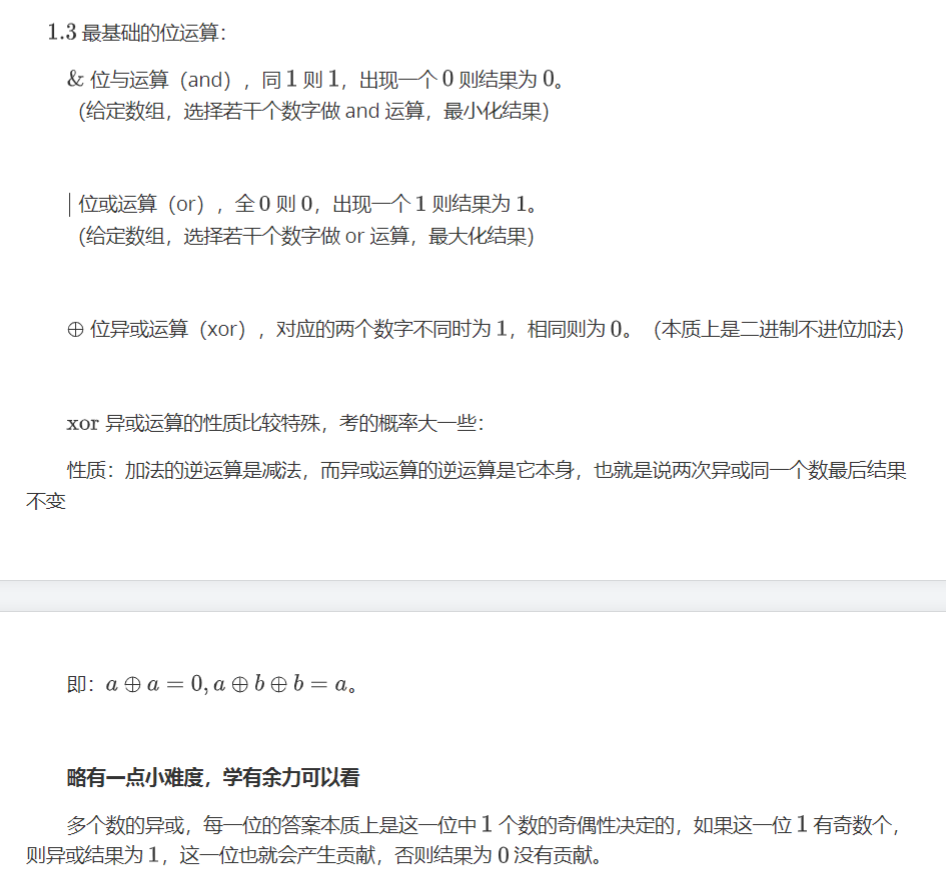
下面用 Python 讲解图片中的三种基础位运算:&、|、^
常见用途:判断奇偶
一个数的二进制最低位:
01所以可以这样判断
x=7
if(x&1): print("奇数")else: print("偶数")7 = 111
111 & 001 = 001
|两个对应位置只要有一个是 1,结果就是 1^两个对应位置不同,结果是 1两个对应位置相同,结果是 0Python
print(5 ^ 5) # 0二进制:
Plain text
101^101---000也就是:
Plain text
a ^ a = 0Python
print(5 ^ 0) # 5即:
Plain text
a ^ 0 = aPython
print(1 ^ 2 ^ 3)print(3 ^ 1 ^ 2)两个结果相同。
即:
Plain text
a ^ b ^ c = c ^ a ^ bPython 本身可以直接交换:
Python
a, b = b, a也可以利用异或:
Python
a = 5b = 3
a = a ^ bb = a ^ ba = a ^ b
print(a) # 3print(b) # 5过程如下:
Plain text
a = 5 ^ 3b = (5 ^ 3) ^ 3 = 5a = (5 ^ 3) ^ 5 = 3不过在 Python 中,推荐使用:
Python
a, b = b, a异或交换主要是帮助理解异或性质。
假设数组中除了一个数只出现一次,其他数都出现两次:
Python
nums = [4, 1, 2, 1, 2, 4, 7]答案是 7。
利用:
Plain text
a ^ a = 0a ^ 0 = a代码:
Python
nums = [4, 1, 2, 1, 2, 4, 7]
answer = 0
for x in nums: answer ^= x
print(answer) # 7展开为:
Plain text
0 ^ 4 ^ 1 ^ 2 ^ 1 ^ 2 ^ 4 ^ 7相同的数会抵消:
Plain text
4 ^ 4 = 01 ^ 1 = 02 ^ 2 = 0最后只剩:
Plain text
7M-小苯的异或疑惑(hard)_北京信息科技大学第十五届程序设计竞赛(同步赛)
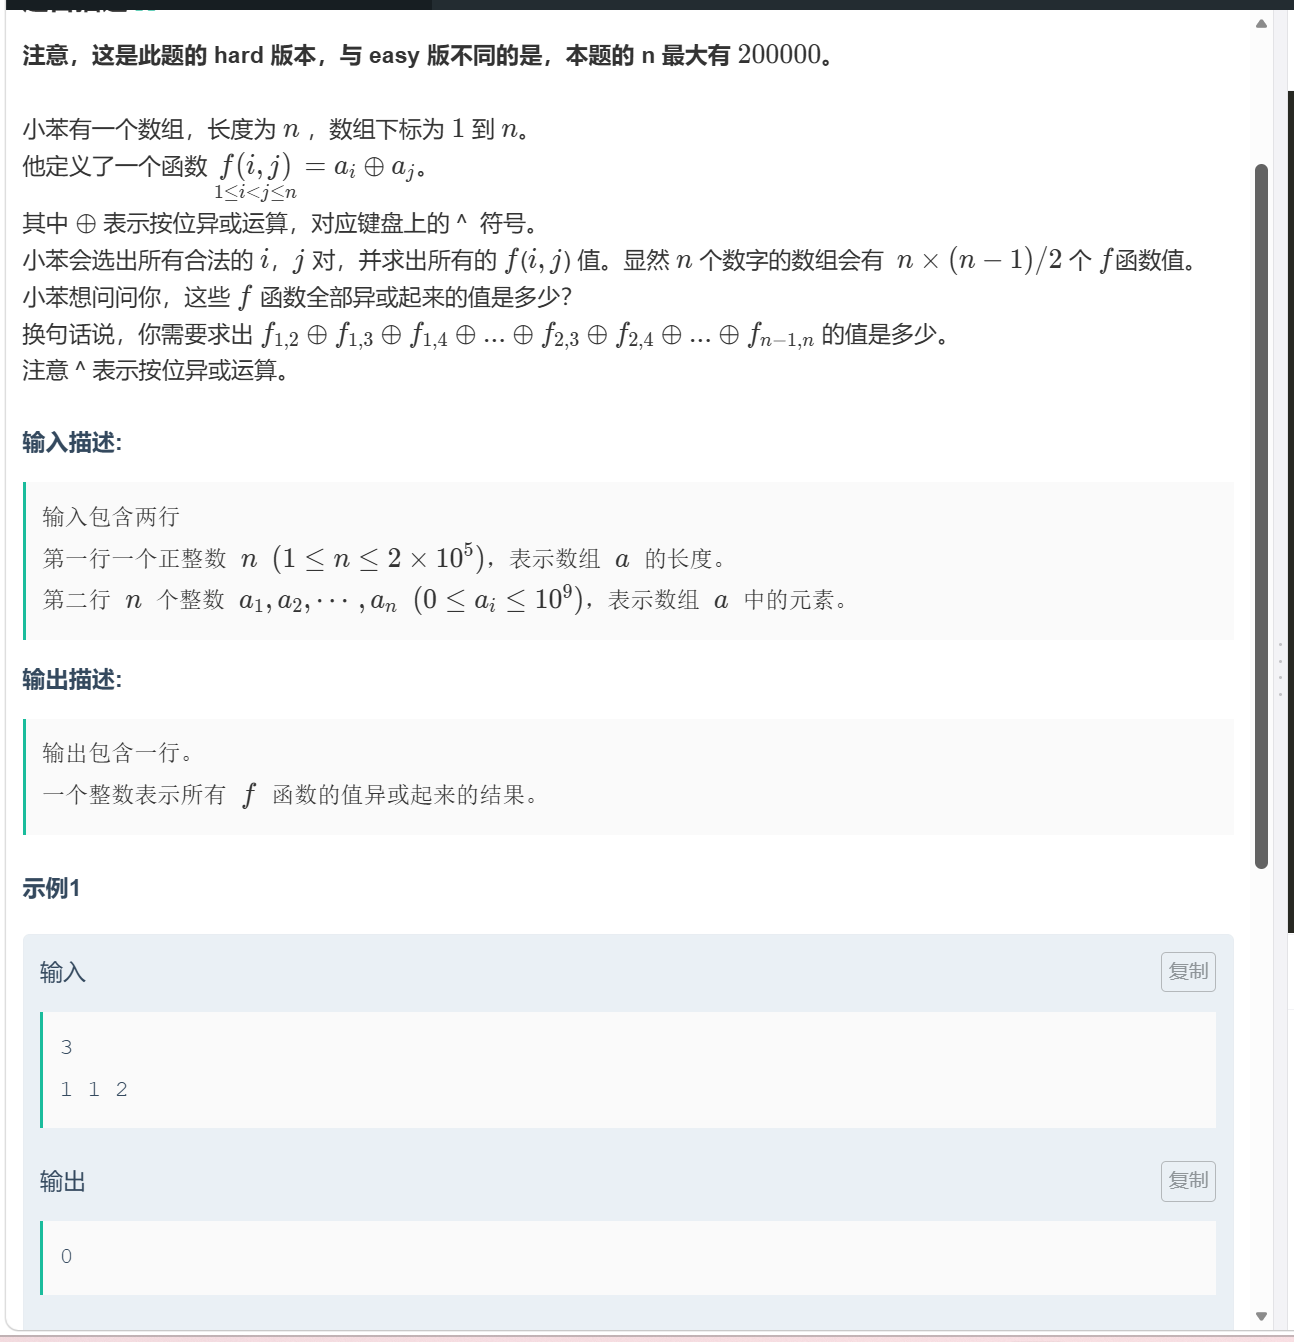
import sysinput = lambda:sys.stdin.readline().strip()
n=int(input())a=list(map(int,input().split()))f=a[0]if(n%2!=0): print(0)else: for i in range(1,n): f^=a[i] print(f)优化思路:统计每个数出现了几次
考虑某个 a[k]:
n - 1 个元素进行异或a[k] 一共出现 n - 1 次而异或有性质:
Plain text
x ^ x = 0所以:
n - 1 是偶数,a[k] 出现偶数次,会全部抵消n - 1 是奇数,a[k] 会保留一次因此:
当 n 为奇数
Plain text
n - 1 为偶数所有元素都抵消,答案是:
Plain text
0当 n 为偶数
Plain text
n - 1 为奇数每个元素保留一次,答案是:
Plain text
a[0] ^ a[1] ^ ... ^ a[n-1]例如:
Python
print(5 ^ 3 ^ 6)二进制:
Plain text
5 = 1013 = 0116 = 110逐位统计:
Plain text
第 1 位:1、0、1,有两个 1,结果为 0第 2 位:0、1、1,有两个 1,结果为 0第 3 位:1、1、0,有两个 1,结果为 0所以:
Plain text
5 ^ 3 ^ 6 = 0异或某一位上出现奇数个 1,结果该位就是 1;出现偶数个 1,结果就是 0。
Python
a = 5 # 101b = 3 # 011
print(a & b) # 1,两个位置都为 1print(a | b) # 7,只要一个位置为 1print(a ^ b) # 6,两个位置不同对应关系:
| 运算 | 规则 | 示例 |
|---|---|---|
& | 都是 1 才是 1 | 5 & 3 = 1 |
| ` | ` | 有一个 1 就是 1 |
^ | 不同为 1,相同为 0 | 5 ^ 3 = 6 |
位运算:
Python
& | ^逻辑运算:
Python
and or not例如:
Python
a = Trueb = False
print(a and b) # False而位运算是对整数的二进制位进行操作:
Python
print(5 & 3) # 1不要混淆:
Python
if x > 0 and y > 0: print("都大于 0")这里应该使用逻辑运算 and,不是 &。
Plain text
&:都为 1 才为 1|:有 1 就为 1^:不同为 1,相同为 0最重要的异或性质:
Python
a ^ a == 0a ^ 0 == a这也是“找只出现一次的数”这类题目的基础。
I-快速夺取_苏州工学院 2026 ACM新生程序设计竞赛同步赛(重现赛)@AuroraSean
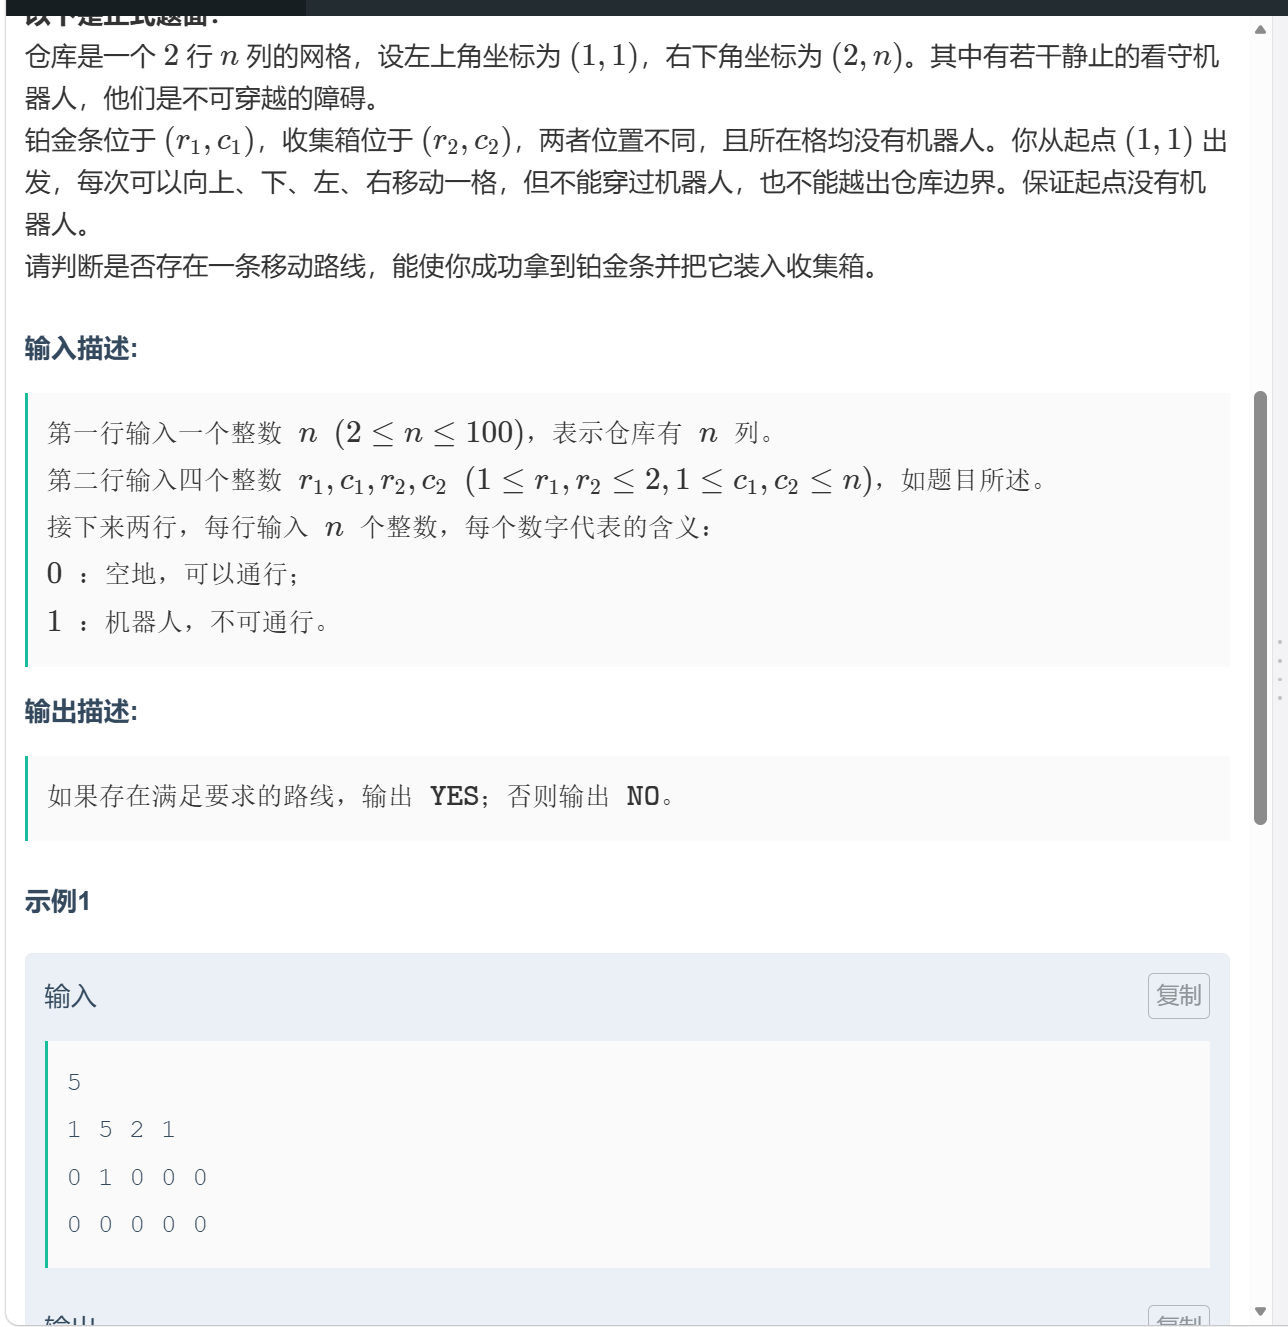
BFS 的全称是:
Breadth First Search,广度优先搜索
它的思想是:
先走距离为 1 的所有位置,再走距离为 2 的所有位置,再走距离为 3 的所有位置……
就像水波纹一样,一层一层向外扩散。
例如地图:
Plain text
起点 . . . . # . . . 终点从起点开始:
Plain text
第 0 层:起点第 1 层:起点周围能走的位置第 2 层:再向外扩展一层第 3 层:继续扩展只要最终扩展到了终点,就说明可以到达。
BFS 通常需要三个东西:
Python
queue # 队列,保存待处理的位置visited # 记录某个位置是否访问过directions # 上下左右四个方向队列有一个特点:
先进先出。
就像排队买饭:
Plain text
先来的人先离开Python 中使用:
Python
from collections import deque
queue = deque()加入元素:
Python
queue.append((x, y))取出最前面的元素:
Python
x, y = queue.popleft()不能使用:
Python
list.pop(0)因为列表头部删除元素很慢,BFS 应该使用 deque。
为什么需要 visited?
因为地图中可能有环。
例如:
Plain text
A -> B -> C ↑ ↓ └────┘如果不记录访问过的位置,就可能一直绕圈。
Python
visited = [[False] * n for _ in range(2)]当访问一个位置时:
Python
visited[x][y] = True从一个格子可以向:
因此可以写:
Python
因为二维数组的行号是**从上到下增加**的。directions = [ (-1, 0), # 上 (1, 0), # 下 (0, -1), # 左 (0, 1) # 右] 行号变小 ↑ |列号变小 ←──── (x, y) ────→ 列号变大 | ↓ 行号变大如果当前位置是:
Python
(x, y)那么下一个位置是:
Python
nx = x + dxny = y + dy下面是一个最基础的 BFS:
Python
from collections import deque
def bfs(start_x, start_y, target_x, target_y, grid): rows = len(grid) cols = len(grid[0])
# visited[x][y] 表示位置 (x, y) 是否访问过 visited = [[False] * cols for _ in range(rows)]
# 创建队列,并把起点加入队列 queue = deque() queue.append((start_x, start_y)) #表示起点访问过 visited[start_x][start_y] = True
# 上、下、左、右 directions = [ (-1, 0), (1, 0), (0, -1), (0, 1) ]
while queue: # 取出队头位置 x, y = queue.popleft()
# 如果到达终点,说明可以到达 if x == target_x and y == target_y: return True
# 尝试向四个方向走 for dx, dy in directions: nx = x + dx ny = y + dy
# 判断是否越界 if nx < 0 or nx >= rows: continue
if ny < 0 or ny >= cols: continue
# 判断是否是机器人 if grid[nx][ny] == 1: continue
# 判断是否已经访问过 if visited[nx][ny]: continue
# 可以走到这个位置 visited[nx][ny] = True queue.append((nx, ny))
# 队列为空,仍然没有找到终点 return False重点看这部分:
Python
while queue: x, y = queue.popleft()只要队列不为空,就不断取出一个位置。
然后:
Python
for dx, dy in directions:尝试从当前位置走向四个方向。
如果新位置合法:
Python
visited[nx][ny] = Truequeue.append((nx, ny))就把它标记为已访问,并放入队列等待处理。
本题有两个重要位置:
Plain text
起点:(1, 1)铂金条:(r1, c1)收集箱:(r2, c2)需要完成:
Plain text
起点 -> 铂金条 -> 收集箱所以可以分成两次 BFS:
如果两次都可以到达,输出:
Plain text
YES否则输出:
Plain text
NO为什么可以分成两次?
因为机器人不能移动,地图不会发生变化。
如果:
Plain text
起点可以到达铂金条铂金条可以到达收集箱那么我们就可以先走到铂金条,再继续走到收集箱。
Python
import sysfrom collections import deque
def bfs(grid, start, target): """ 判断从 start 是否可以走到 target。
参数: grid : 地图,0 表示可以走,1 表示机器人 start : 起点坐标 (行, 列) target : 终点坐标 (行, 列)
返回: True : 可以到达 False : 无法到达 """
rows = 2 cols = len(grid[0])
start_x, start_y = start target_x, target_y = target
# visited[x][y] 表示位置 (x, y) 是否访问过 visited = [[False] * cols for _ in range(rows)]
# 使用队列保存待搜索的位置 queue = deque()
# 从 start 开始搜索 queue.append((start_x, start_y)) visited[start_x][start_y] = True
# 上、下、左、右 directions = [ (-1, 0), # 上 (1, 0), # 下 (0, -1), # 左 (0, 1) # 右 ]
while queue: # 取出队头位置 x, y = queue.popleft()
# 到达目标 if x == target_x and y == target_y: return True
# 尝试四个方向 for dx, dy in directions: nx = x + dx ny = y + dy
# 不能越界 if nx < 0 or nx >= rows: continue
if ny < 0 or ny >= cols: continue
# 不能走到机器人所在的位置 if grid[nx][ny] == 1: continue
# 已经访问过的位置不再访问 if visited[nx][ny]: continue
# 标记并加入队列 visited[nx][ny] = True queue.append((nx, ny))
# 搜索结束仍未找到目标 return False
# 读取所有输入data = list(map(int, sys.stdin.buffer.read().split()))
# 读取列数n = data[0]
# 读取两个目标的位置r1, c1, r2, c2 = data[1:5]
# 转成 Python 的 0-based 下标r1 -= 1c1 -= 1r2 -= 1c2 -= 1
# 读取地图grid = [ data[5:5 + n], data[5 + n:5 + 2 * n]]
# 起点是 (1, 1),转换成 0-based 后是 (0, 0)start = (0, 0)
# 铂金条位置gold = (r1, c1)
# 收集箱位置box = (r2, c2)
# 第一步:起点能否到达铂金条can_reach_gold = bfs(grid, start, gold)
# 第二步:铂金条能否到达收集箱can_reach_box = bfs(grid, gold, box)
if can_reach_gold and can_reach_box: print("YES")else: print("NO")假设:
Plain text
n = 5铂金条 = (1, 3)收集箱 = (2, 5)地图:
Plain text
0 0 0 1 00 1 0 0 0起点:
Plain text
(1, 1)第一次 BFS:
Plain text
(1,1) -> (1,2) -> (1,3)可以拿到铂金条。
第二次 BFS:
Plain text
(1,3) -> (2,3) -> (2,4) -> (2,5)可以到达收集箱。
因此输出:
Plain text
YES代码中:
Python
queue.append((start_x, start_y))visited[start_x][start_y] = True必须立刻标记。
如果不立刻标记,可能出现:
Plain text
起点 -> 右边 -> 起点然后起点又被重复加入队列。
正确做法是:
一个位置第一次加入队列时,就标记为访问过。
而不是等它从队列取出来时再标记。
以后遇到网格搜索题,可以按这五步想:
本题中一个位置是:
Python
(row, col)也就是:
Python
(行号, 列号)本题可以上下左右移动:
Python
directions = [ (-1, 0), (1, 0), (0, -1), (0, 1)]有三种:
使用:
Python
visited当前位置等于目标位置:
Python
if (x, y) == target: return True| 方法 | 搜索方式 | 常用数据结构 |
|---|---|---|
| BFS | 一层一层搜索 | 队列 |
| DFS | 一条路走到底 | 栈或递归 |
如果题目问:
最少走多少步?
在每一步代价相同的情况下,优先使用 BFS,因为 BFS 第一次到达终点时,一定是最短路。
本题只问:
能不能到达?
BFS 和 DFS 都可以,但 BFS 更适合练习网格搜索。
m, n = len(maze), len(maze[0])vis = [[False] * n for _ in range(m)]dirc = [(1, 0), (-1, 0), (0, 1), (0, -1)]
def InArea(x, y): return 0 <= x < m and 0 <= y < n
def dfs(x, y): if not InArea(x, y) or vis[x][y] == True: return vis[x][y] = True for dx, dy in dirc: dfs(x + dx, y + dy) returnclass Solution: def numIslands(self, grid: List[List[str]]) -> int: n=len(grid) m=len(grid[0]) ans=0 vis=[[False]*m for _ in range(n)]#先列后行 dirc =[(1,0),(-1,0),(0,1),(0,-1)] def inarea(x,y): return 0<=x<n and 0<=y<m # 深度优先搜索,标记同一个岛屿 def dfs(x,y): # 越界、访问过、或者是水,直接返回 if not inarea(x,y) or vis[x][y]==True or grid[x][y]=="0":# “0” 要加""号 return # 标记当前位置 vis[x][y]=True # 搜索上下左右 for dx,dy in dirc: dfs(x+dx,y+dy) return
for i in range(n): for j in range(m): # 找到一个未访问的陆地,说明发现了一个新岛屿 if(grid[i][j]=="1" and vis[i][j]==False): ans+=1 dfs(i,j) return ans每次进入一个新的陆地格子后,又会执行:
for dx, dy in dirc: dfs(新的坐标)所以它不是只检查起点附近,而是:
当前格子 -> 邻居格子 -> 邻居的邻居 -> 更外层的格子这就是递归不断向外扩展的过程。
当它尝试走到水、越界或已经访问过的位置时,触发:
if not inarea(x, y) or vis[x][y] or grid[x][y] == "0": return此时这一次递归调用结束,返回上一个格子,继续检查上一个格子的其他方向。
例如遇到水:
1 1 10 0 1从 (0, 0) 可以走到 (0, 1),再到 (0, 2),再到 (1, 2)。尝试走到 (1, 1) 时发现是水:
grid[1][1] == "0"于是:
return但这只代表当前这条方向停止,不是整个 DFS 停止。程序会回到上一级,继续尝试其他方向。
可以把它理解为走迷宫:
dfs:沿着一条路继续走所以 return 只结束当前递归调用,不会立即结束所有搜索。
所以一次 dfs 实际上会标记:
从起点出发,所有能够通过上下左右走到的陆地。
而题目中规定:
上下左右相连的一整块陆地称为一个岛屿。
因此,一次 dfs 标记的所有陆地,恰好就是一整座岛屿。
外层循环负责寻找新的岛屿:
for i in range(n): for j in range(m): if grid[i][j] == "1" and not vis[i][j]: ans += 1 dfs(i, j)I-快速夺取_苏州工学院 2026 ACM新生程序设计竞赛同步赛(重现赛)@AuroraSean
当然可以。DFS 和 BFS 都是“搜索地图”,区别是:
这道题只问“能不能到达”,所以 DFS 可以解决。
假设现在在位置 (x, y):
True;True。核心代码:
Python
def dfs(x, y): if 到达终点: return True
标记当前位置已经访问
for 四个方向: if 这个方向可以走: if dfs(下一个位置): return True
return Falsevisited?地图中可能有环:
Plain text
A -> B↑ ↓D <- C如果不记录访问过的位置,就可能:
Plain text
A -> B -> C -> D -> A -> B -> ...无限循环。
所以当前位置第一次进入 DFS 时,就要立刻标记:
Python
visited[x][y] = True注意:判断能不能到达时,不需要取消标记。
Python
def dfs(x, y): # 如果到达目标,搜索成功 if (x, y) == target: return True
# 标记当前位置已经访问过 visited[x][y] = True
# 尝试上、下、左、右四个方向 for dx, dy in directions: nx = x + dx ny = y + dy
# 越界,跳过 if nx < 0 or nx >= 2 or ny < 0 or ny >= n: continue
# 有机器人,跳过 if grid[nx][ny] == 1: continue
# 已经访问过,跳过 if visited[nx][ny]: continue
# 递归搜索下一个位置 if dfs(nx, ny): return True
# 四个方向都走不到目标 return False这里最重要的是这一句:
Python
if dfs(nx, ny): return True意思是:
如果从下一个位置出发能够到达终点,那么当前搜索也成功。
Python
import sys
def can_reach(grid, start, target): """ 判断从 start 是否可以走到 target。
grid 中: 0 表示可以走 1 表示有机器人,不能走 """
rows = 2 cols = len(grid[0])
# visited[x][y] 表示位置 (x, y) 是否访问过 visited = [[False] * cols for _ in range(rows)]
# 上、下、左、右 directions = [ (-1, 0), # 上 (1, 0), # 下 (0, -1), # 左 (0, 1) # 右 ]
def dfs(x, y): # 到达目标 if (x, y) == target: return True
# 标记当前位置,防止重复搜索 visited[x][y] = True
# 尝试四个方向 for dx, dy in directions: nx = x + dx ny = y + dy
# 不能越界 if nx < 0 or nx >= rows: continue
if ny < 0 or ny >= cols: continue
# 不能走到机器人位置 if grid[nx][ny] == 1: continue
# 已经访问过的位置不再搜索 if visited[nx][ny]: continue
# 如果从下一个位置能到达目标,搜索成功 if dfs(nx, ny): return True
# 四个方向都无法到达目标 return False
# 从 start 开始搜索 return dfs(start[0], start[1])
# 读取所有输入data = list(map(int, sys.stdin.buffer.read().split()))
# 读取列数n = data[0]
# 读取铂金条和收集箱的位置r1, c1, r2, c2 = data[1:5]
# 题目坐标从 1 开始,Python 下标从 0 开始r1 -= 1c1 -= 1r2 -= 1c2 -= 1
# 读取两行地图grid = [ data[5:5 + n], data[5 + n:5 + 2 * n]]
# 起点 (1, 1) 转换成 Python 下标后是 (0, 0)start = (0, 0)
# 铂金条位置gold = (r1, c1)
# 收集箱位置box = (r2, c2)
# 第一步:起点能否到达铂金条if not can_reach(grid, start, gold): print("NO")else: # 第二步:拿到铂金条后,能否到达收集箱 if can_reach(grid, gold, box): print("YES") else: print("NO")假设当前地图是:
Plain text
0 0 11 0 0从左上角开始:
Plain text
(0, 0)DFS 可能这样搜索:
Plain text
dfs(0, 0) 尝试上:越界 尝试下:机器人 尝试左:越界 尝试右:进入 (0, 1)
dfs(0, 1) 尝试下:进入 (1, 1)
dfs(1, 1) 尝试右:进入 (1, 2)
dfs(1, 2) 到达目标 返回 True返回过程:
Plain text
dfs(1, 2) 返回 Truedfs(1, 1) 返回 Truedfs(0, 1) 返回 Truedfs(0, 0) 返回 True所以最终判断可以到达。
例如:
Plain text
0 0 11 0 10 1 0如果某个方向走不通,递归函数会执行:
Python
return False然后回到上一个位置,继续尝试其他方向。
这就叫:
回溯。
但要注意:
Python
visited[nx][ny] = False在本题中不需要写。
因为我们只是判断“是否存在一条路”。一个位置如果已经搜索过,并且从它出发到不了目标,那么之后再次来到它,也不会有新的结果。
Python
queue.append(start)
while queue: x, y = queue.popleft() ...使用队列,一层一层搜索。
Python
def dfs(x, y): ... dfs(nx, ny)使用递归,一条路走到底。
| 对比 | BFS | DFS |
|---|---|---|
| 主要结构 | 队列 | 递归/栈 |
| 搜索特点 | 一层一层 | 一条路走到底 |
| 能否判断可达 | 可以 | 可以 |
| 是否保证最短路 | 可以 | 不保证 |
| 本题能否使用 | 可以 | 可以 |
题目只要求输出:
Plain text
YES 或 NO也就是只关心:
是否存在一条合法路径。
DFS 会尝试所有可能路线:
True;False。因此完全符合题目要求。
时间复杂度为:
Plain text
O(行数 × 列数) = O(2n) = O(n)因为每个位置最多访问一次。
暂未播放
全站壁纸和首页壁纸可分别设置,默认亮暗主题壁纸保持不变;图片仅保存在本机浏览器。
保存后首页立即生效,仅保存在本机浏览器。


评论 0
还没有评论,来说第一句吧。